پایلوت هوش مصنوعی را چطور انتخاب کنیم که در دمو نماند
چرا پایلوت هوش مصنوعی در دمو میماند؟ چهار پرسش پیشنهادی پیش از شروع: داده، نقطهٔ اتصال، مالک کسبوکاری و شاخص موفقیت، بههمراه یک قاعدهٔ توقف.
فهرست مطالب
اگر چند پروژهٔ آزمایشی هوش مصنوعی دارید و هیچکدام از جلسهٔ دمو جلوتر نرفته، این یادداشت برای شماست. اینجا میخوانید چرا این پروژهها آزمایشی میمانند و از روز اول چطور پروژهای انتخاب کنید که به کار روزمره برسد. پایلوت (pilot) یعنی اجرای کوچک و آزمایشی یک ابزار روی بخشی از کار، پیش از استفادهٔ کامل. گزارشی از ابتکار NANDA در MIT که فورچون در اوت ۲۰۲۵ پوشش داد، میگوید فقط حدود ۵ درصد برنامههای آزمایشی هوش مصنوعی به شتاب سریع درآمد رسیدهاند[۱]. به گفتهٔ همین گزارش، مشکل اصلی کیفیت مدل نیست. گزارش از شکاف یادگیری (learning gap) حرف میزند، یعنی ابزارها و سازمانها از هم یاد نمیگیرند، و به یکپارچهسازی معیوب با سازمان اشاره میکند[۱]. برداشت ما این است که بخش بزرگی از این شکست پیش از شروع پایلوت رقم میخورد. همان لحظهای که پایلوت را بهخاطر دموی جذابش انتخاب میکنیم، نه بهخاطر مسیر روشنش به داده، به سامانههای واقعی و به یک مالک مشخص.
واقعیتهای کلیدی
- طبق گزارش MIT به روایت فورچون، فقط حدود ۵ درصد برنامههای آزمایشی هوش مصنوعی به شتاب سریع درآمد رسیدهاند.[۱]
- پژوهش MIT علت اصلی را یکپارچهسازی معیوب با سازمان میداند، نه کیفیت مدل.[۱]
- خرید از فروشندگان تخصصی و همکاری با آنها حدود ۶۷ درصد مواقع موفق بوده و ساخت داخلی یکسوم این نرخ را داشته است.[۱]
- بیش از نیمی از بودجهٔ هوش مصنوعی مولد صرف فروش و بازاریابی میشود، اما بیشترین بازده در خودکارسازی کارهای پشتصحنه دیده شده است.[۱]
- راهنمای آموزشی مایکروسافت، که متن خود این فروشنده است، پیشنهاد میکند ایدهها به ۳ تا ۵ گزینه بر اساس ارزش، آمادگی داده و زمان رسیدن به نتیجه محدود شوند.[۵]
کجای کسبوکار شما به کار میآید؟
مدیریت و تصمیمگیری — مدیرعامل یا مدیر عملیات کسبوکار متوسط: میتوانید پیش از تأیید هر پایلوت، آن را با چهار پرسش داده، نقطهٔ اتصال، مالک و شاخص بسنجید و برایش تاریخ بازبینی و شرط بستن بنویسید.
قدم اول: این ماه فهرست پایلوتهای جاری را در یک برگه بنویسید و جلوی هر کدام مالک، سامانهای که به آن وصل میشود و شاخص را پر کنید. هر ردیفی که خالی ماند، نامزد توقف است.
زحمت: کم · حواستان باشد: قاعدهٔ توقف فقط وقتی کار میکند که از قبل نوشته شود و به آن پایبند بمانید. تاریخ بازبینی را نباید بعداً عقب انداخت.
محصول و فناوری — مسئول فناوری یا محصول فروشگاه آنلاین: میتوانید پیش از ساختن، سادهترین راهحل را امتحان کنید. اول روشن کنید ابزار چطور به CRM، انبار یا حسابداری وصل میشود، بعد سراغ انتخاب مدل بروید.
قدم اول: برای یک پایلوت بنویسید ابزار دقیقاً چه دادهای را از کدام سامانه میخواند و کجا مینویسد. بعد بپرسید آیا ابزار آمادهای این اتصال را دارد.
زحمت: متوسط · حواستان باشد: نرمافزارهای داخلی ممکن است راه آمادهای برای اتصال نداشته باشند و کار به همکاری با سازندهٔ آن نرمافزار بکشد.
عملیات و زنجیره تأمین — مدیر مالی یا مدیر پشتیبانی شرکت خدماتی: میتوانید پایلوت بعدی را بهجای ابزار بازاریابی، روی یک کار تکراری پشتصحنه مثل ثبت فاکتور یا پاسخ به پرسشهای تکراری تعریف کنید؛ MIT بیشترین بازده را در این حوزه دیده است[۱].
قدم اول: یک کار تکراری پشتصحنه انتخاب کنید که امروز زمان یا هزینهٔ برونسپاریاش را میدانید و همان را نقطهٔ شروع مقایسه بگیرید.
زحمت: متوسط · حواستان باشد: اگر وضعیت فعلی را اندازه نگیرید، بعداً نمیتوانید اثر پایلوت را نشان دهید. دادهٔ حساس مالی هم باید دسترسی کنترلشده داشته باشد.
آمار شکست پایلوتها دقیقاً چه چیزی را میسنجد
این گزارش بر پایهٔ ۱۵۰ مصاحبه با مدیران، نظرسنجی از ۳۵۰ کارمند و بررسی ۳۰۰ پروژهٔ عمومی هوش مصنوعی تهیه شده است[۱]. معیار موفقیت در آن، شتاب سریع درآمد و اثر قابل اندازهگیری بر سود و زیان (P&L) است[۱]. به گفتهٔ نویسندهٔ اصلی، شرکتها اغلب دوست نداشتند نرخ شکست را بگویند[۱]. ما هم گزارش را فقط از روایت فورچون میشناسیم و روش آن را مستقیم بررسی نکردهایم. برداشت ما این است که تیتر شکست گستردهٔ پایلوتها کمی بزرگتر از خود یافته است. پایلوتی که با این معیار شکست خورده، لزوماً فناوری بیفایدهای نبوده است. فقط اثرش در حساب سود و زیان دیده نشده است.
گزارش سراغ علت هم رفته است. به گفتهٔ فورچون، مدیران معمولاً مقررات یا عملکرد مدل را مقصر میدانند، اما پژوهش MIT به یکپارچهسازی معیوب با سازمان اشاره میکند[۱]. نویسندهٔ اصلی گزارش توضیح داده که ابزارهای عمومی مثل ChatGPT برای افراد خوب کار میکنند، چون انعطاف دارند. اما در سازمان گیر میکنند، چون از روند کار یاد نمیگیرند و با آن جور نمیشوند[۱].
دو یافتهٔ دیگر هم به تصمیم مدیر ربط دارد. بیش از نیمی از بودجهٔ هوش مصنوعی مولد، یعنی ابزارهایی که متن یا تصویر میسازند، صرف ابزارهای فروش و بازاریابی میشود. ولی MIT بیشترین بازده را در خودکارسازی کارهای پشتصحنه (back-office) دیده است، مثل کمکردن برونسپاری و هزینهٔ آژانسهای بیرونی[۱]. یافتهٔ دوم این است که خرید ابزار از فروشندگان تخصصی و همکاری با آنها حدود ۶۷ درصد مواقع موفق بوده و ساخت داخلی فقط یکسوم این نرخ را داشته است[۱].
چهار پرسش پیشنهادی ما پیش از شروع هر پایلوت
فرض کنید یک فروشگاه آنلاین چتباتی آزمایش کرده که در دمو روان به مشتری جواب میدهد. اما چتبات به موجودی انبار و وضعیت سفارش وصل نیست. کسی هم در تیم فروش مسئول نتیجهاش نیست. به نظر میرسد چنین پایلوتی با هر مدلی در همان دمو میماند. یک مقالهٔ پژوهشی، در مرور کارهای پیشین دربارهٔ یادگیری ماشین، به پژوهشی اشاره میکند که نشان داده بود مشکلات سازمانی جلوی رسیدن مدل به استفادهٔ واقعی را میگیرند[۳]. نمونهاش تیمهای پراکنده یا کمبود دانش داده در مدیریت است[۳].
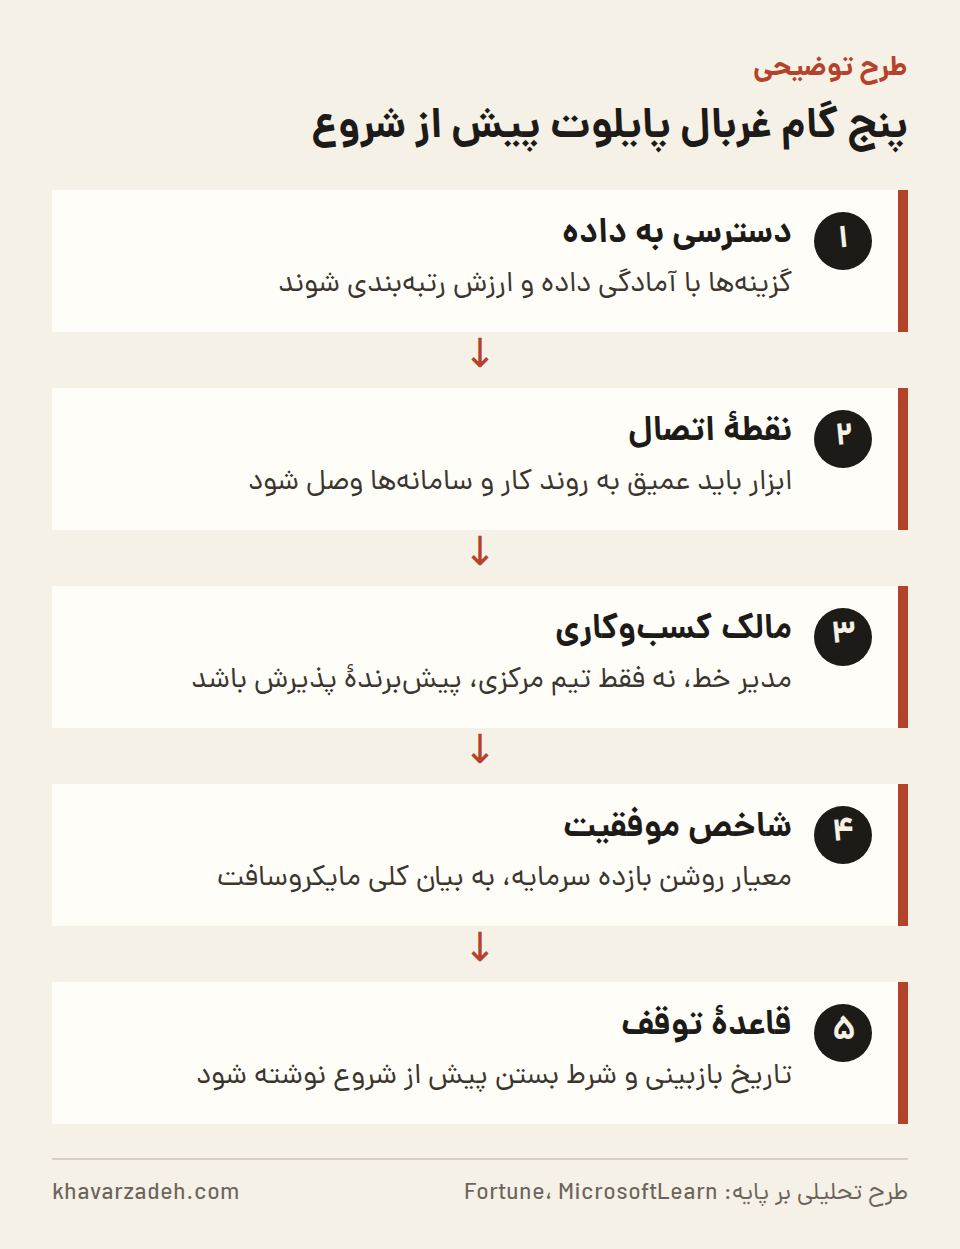
چهار پرسشی که در ادامه میآید جمعبندی ما از چند منبع است، نه فهرستی که یکی از منابع داده باشد. پرسش اول دسترسی به داده است و منابع فقط تا حدی پشتش هستند. نزدیکترین پشتوانه، راهنمای آموزشی مایکروسافت است. این متن را خود فروشنده نوشته و مسیر پیشنهادیاش به تیم حساب مایکروسافت و ابزارهای خود این شرکت گره خورده است[۵]. پس بهتر است آن را دیدگاه یک فروشنده بخوانید، نه مرجعی بیطرف. این راهنما پیشنهاد میکند ایدهها در کارگاههایی با صاحبان فرایند به ۳ تا ۵ گزینهٔ برتر برسند و بر اساس ارزش، آمادگی داده و زمان رسیدن به نتیجه رتبهبندی شوند[۵].
پرسش دوم نقطهٔ اتصال است: پایلوت دقیقاً کجا به CRM (سامانهٔ مدیریت ارتباط با مشتری)، حسابداری یا انبار وصل میشود. MIT انتخاب ابزارهایی را که عمیق وصل شوند و با گذر زمان خودشان را تطبیق دهند از عوامل موفقیت میداند[۱]. Anthropic هم توصیه میکند سادهترین راهحل ممکن انتخاب شود. به گفتهٔ این شرکت، برای بسیاری از کاربردها یک بار صدا زدن مدل همراه با بازیابی اطلاعات و چند نمونه کافی است[۲]. عامل (agent) یعنی سامانهای که خودش چند گام کار را پشت سر هم انجام میدهد. یک مقالهٔ پژوهشی دربارهٔ الگوهای استقرار در سازمانها استدلال میکند سازمانهایی که بدون تجربهٔ الگوهای سادهتر سراغ چند عامل هوشمند هماهنگ میروند، به شکستهایی برمیخورند که ریشهاش نبود ابزار نظارت و ثبت سوابق است[۴].
پرسش سوم مالک کسبوکاری است. MIT توانمندکردن مدیران خط، و نه فقط یک آزمایشگاه مرکزی هوش مصنوعی، را از عوامل موفقیت میشمارد[۱]. پرسش چهارم شاخص موفقیت است. مایکروسافت فقط بهطور کلی از معیارهای روشن بازده سرمایه در مسیر پایلوت تا استفادهٔ کامل حرف میزند[۵]. باقی این معیار برداشت ماست. شاخص باید عددی باشد که مالک فرایند هر هفته نگاهش میکند، مثل زمان پاسخ به مشتری یا خطای ثبت فاکتور. بهتر است استفاده واقعی را در سطح وظیفه بسنجید، نه با تعداد کاربر یا لایسنس.
پیش از شروع بنویسید پایلوت کی بسته میشود
Anthropic برای عاملهای هوشمند توصیه میکند شرط توقف، مثل سقف تعداد تکرار، از قبل تعیین شود تا کنترل از دست نرود[۲]. به نظر ما همین منطق برای خود پایلوت هم جواب میدهد. پیش از شروع، یک تاریخ بازبینی بنویسید. اگر تا آن روز داده وصل نشده، مالک فرایند از ابزار استفاده نمیکند یا شاخص تکان نخورده، پایلوت را ببندید. به برداشت ما، بستن زودهنگام شکست نیست. این کار وقت و نیروی تیم را برای پایلوت بعدی آزاد میکند.
مایکروسافت از خطر پراکندگی پایلوتها حرف میزند و پیشنهاد میکند پروژههای پراکنده جای خود را به سبدی متمرکز و رتبهبندیشده بدهند[۵]. به برداشت ما، پیامد احتمالی این کار این است که تعداد پایلوتها کم میشود ولی هر کدام زودتر اثرش در حساب سود و زیان دیده میشود. اگر هنوز روشن نیست چه کسی در شرکت شما مسئول هوش مصنوعی است، بحث مدل عملیاتی هوش مصنوعی هم ارزش بازنگری دارد. در گزارش MIT، خرید و همکاری بیشتر از ساخت داخلی موفق بوده است[۱]. پس به برداشت ما، پیش از ساختن بپرسید آیا ابزار آمادهای هست که به سامانههای شما وصل شود.
| معیار | پرسش پیش از شروع | آنچه منابع میگویند |
|---|---|---|
| دسترسی به داده | دادهٔ لازم آماده و قابل دسترسی است؟ | راهنمای آموزشی مایکروسافت (متن فروشنده) آمادگی داده را یکی از معیارهای رتبهبندی میداند |
| نقطهٔ اتصال | به CRM، حسابداری یا انبار کجا وصل میشود؟ | MIT یکپارچهسازی عمیق را عامل موفقیت میداند |
| مالک کسبوکاری | کدام مدیر خط مسئول نتیجه است؟ | MIT توانمندکردن مدیران خط را عامل موفقیت میداند |
| شاخص موفقیت | کدام عدد باید جابهجا شود؟ | مایکروسافت فقط بهطور کلی از معیارهای روشن بازده سرمایه حرف میزند |
| سادگی راهحل | سادهترین راه کافی است؟ | Anthropic سادهترین راهحل ممکن را توصیه میکند |
خط زمانی
- 2025-08-18: فورچون گزارش ابتکار NANDA در MIT دربارهٔ نتایج پایلوتهای هوش مصنوعی مولد در شرکتها را پوشش داد.[۱]
برای کسبوکارهای ایرانی
یافتهٔ MIT دربارهٔ برتری خرید و همکاری بر ساخت داخلی[۱] برای کسبوکار ایرانی هم به کار میآید. اگر خرید از فروشندهٔ تخصصی خارجی برای شما ممکن یا ساده نیست، شاید بتوانید پیش از ساخت ابزار اختصاصی با یک شریک داخلی کار کنید که نرمافزار حسابداری، CRM یا انبار شما را میشناسد. برداشت ما این است که در این شرایط، نقطهٔ اتصال به سامانهٔ موجود از انتخاب مدل مهمتر است.
چه چیزی را باید دنبال کرد
- آیا گزارشهای بعدی MIT یا پژوهشهای مشابه، موفقیت پایلوتها را با معیاری جز شتاب درآمد هم میسنجند.
- آیا ابزارهای اتصال استاندارد مثل Model Context Protocol که Anthropic معرفی کرده، هزینهٔ وصلکردن مدل به سامانههای موجود را برای کسبوکارهای کوچک کم میکنند.
- در شرکت خودتان: در تاریخ بازبینی هر پایلوت، آیا شاخص تعیینشده تکان خورده یا باید پایلوت بسته شود.
دادههای مرتبط در همین سایت: دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- MIT report: 95% of generative AI pilots at companies are failing | Fortune — Fortune، انتشار: 2025-08-18، شواهد تازه، دسترسی: 2026-10-13
- Building Effective AI Agents — AnthropicAI، منبع مرجع، دسترسی: 2026-10-13
- Practitioners’ Discussions on Building LLM-based Applications for Production — arxiv.org، منبع مرجع، دسترسی: 2026-10-13
- From Chatbot to Agent Fleet: A Deployment Pattern Taxonomy for Enterprise LLM Systems — neurips.cc، منبع مرجع، دسترسی: 2026-10-13
- Unlock AI value - Training — MicrosoftLearn، منبع مرجع، دسترسی: 2026-10-13
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-13.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر