نرخ خرید دوبارهای که کمبرآورد است: وقتی یک مشتری در چند رکورد ثبت میشود
وقتی یک خریدار در چند رکورد ثبت میشود، سنجههای نگهداشت مشتری کمبرآورد میشوند؛ چرا این خطا یکطرفه است و با چه قدمهای ارزانی اصلاح میشود.
فهرست مطالب
اگر داشبورد شما میگوید بیشتر مشتریان فقط یک بار خرید کردهاند، پیش از بالا بردن بودجهٔ جذب یک چیز را بررسی کنید: شمارش مشتری. این نوشته برای مالک یا مدیری است که پول بازاریابی را بین جذب مشتری تازه و نگهداشتن مشتری فعلی تقسیم میکند و به سنجههای تکرار خرید تکیه دارد. AWS مثال سادهای میزند. کسی با جیمیل شخصی از سایت کفش میخرد. دو هفته بعد با ایمیل کاری عضو باشگاه مشتریان میشود. ماه بعد در فروشگاه حضوری شمارهٔ دیگری میدهد. سیستمها سه مشتری میبینند، در حالی که یک نفر است[۱]. به گفتهٔ AWS نتیجهٔ این پراکندگی، پرداخت تبلیغات برای مخاطب تکراری، شخصیسازی ضعیف و تصویر ناقص از ارزش عمر مشتری است[۱]. این سنجه یعنی مجموع سودی که یک مشتری در طول رابطهاش با شما میسازد. برداشت ما این است که خطا تصادفی نیست و فقط در یک جهت کار میکند. مشتری وفادار را به چند مشتری تازه تکه میکند و هزینهٔ جذب را موجه جلوه میدهد. قدم اول اصلاحش هم یک پروژهٔ بزرگ نیست.
واقعیتهای کلیدی
- به توضیح AWS، یک خریدار که با ایمیل شخصی آنلاین خرید میکند، با ایمیل کاری عضو باشگاه مشتریان میشود و در فروشگاه شمارهٔ دیگری میدهد، در سیستمها سه مشتری جدا دیده میشود.[۱]
- AWS میگوید پیامد پراکندگی هویت مشتری، هزینهٔ تبلیغات تکراری روی یک نفر، شخصیسازی ضعیف و محاسبهٔ نادرست ارزش عمر مشتری است.[۱]
- در آزمون AWS و Amperity روی یک دادهٔ نمونه، رکوردهای تکراری ۴۳ درصد کم شد و پس از ادغام ۸۳ درصد رکوردها در ردهٔ شناختهشده قرار گرفت؛ این ارقام ادعای همین منبع است.[۱]
- در یکی از نوشتههای AWS، با ارجاع به دادهٔ نقلشده از فوربز، حدود ۹۰ درصد ترافیک سایتها بازدیدکنندهٔ ناشناس توصیف شده است.[۳]
- به گفتهٔ AWS تطبیق با دقت کامل روی دادهٔ واقعی و حجم بزرگ عملی نیست؛ شرکتها باید حد قابل قبول تعیین کنند و نتیجه را با یک مجموعهٔ حقیقت پایهٔ داوریشده بسنجند.[۲]
- از ژوئن ۲۰۲۵ تطبیق قاعدهمحور نزدیک به زمان واقعی به AWS Entity Resolution اضافه شد و برای رکورد تازه در چند ثانیه شناسهٔ تطبیق برمیگردد.[۴]
کجای کسبوکار شما به کار میآید؟
تحلیل داده — تحلیلگر داده یا مسئول گزارشهای فروشگاه آنلاین: میتوانید یک ستون شناسهٔ نرمالشده بسازید، مثلاً شمارهٔ موبایل با یک قاعدهٔ ثابت. بعد تعداد مشتری یکتا و نرخ خرید دوباره را یک بار با رکوردهای خام و یک بار با شناسهٔ یکپارچه حساب کنید. اختلاف این دو عدد، اندازهٔ خطای شمارش شماست.
قدم اول: یک کوئری بنویسید که رکوردهای مشتری را بر اساس شمارهٔ نرمالشده گروه کند و فهرست گروههایی را که بیش از یک رکورد دارند بیرون بدهد؛ همان فهرست، نقشهٔ کار ادغام است.
زحمت: کم · حواستان باشد: ادغام بیش از حد سخاوتمند میتواند دو نفر را یکی کند؛ AWS میگوید آدرس و تلفن مشترک در خانوار همین خطا را میسازد و باید سطح تطبیق را آگاهانه انتخاب کرد[۲].
بازاریابی و تبلیغات — مدیر بازاریابی فروشگاه آنلاین یا شرکت خدماتی: میتوانید پیش از هر کمپین، مخاطبان تکراری را با شناسهٔ یکپارچه حذف کنید تا برای یک نفر چند بار هزینه نکنید. بعد سهم بودجهٔ نگهداشت را با عدد تصحیحشدهٔ تکرار خرید دوباره بچینید.
قدم اول: لیست مخاطبان آخرین کمپین را با شناسهٔ نرمالشده بازسازی کنید و ببینید چند درصد از ارسالها به یک شخص تکراری رفته است.
زحمت: متوسط · حواستان باشد: درست شدن عدد خودش فروش نمیآورد؛ AWS هم ۴۳ درصد کاهش رکورد تکراری را دربارهٔ رکورد گزارش میکند نه درآمد[۱].
خدمات مشتری — سرپرست پشتیبانی یا مرکز تماس: میتوانید در لحظهٔ تماس، سابقهٔ خرید همان شخص را با یک شناسهٔ مشترک بالا بیاورید. اینطور مشتری قدیمی را مثل مشتری تازه تحویل نمیگیرید. AWS همین تطبیق چندثانیهای را برای شناختن مشتری وفادار در مرکز تماس مثال میزند[۴].
قدم اول: در پنل پشتیبانی، جستوجو را از شمارهٔ خام به شمارهٔ نرمالشده تغییر دهید تا سفارش تلفنی و خرید سایت یک نفر در یک صفحه دیده شود.
زحمت: متوسط · حواستان باشد: نسخهٔ لحظهای این کار در سرویسهای ابری بینالمللی ارائه میشود[۴] و دسترسی و پرداخت آن برای کسبوکارهای ایرانی ساده نیست؛ جستوجوی نرمالشده در CRM خودتان جایگزین در دسترستری است.
مالی و قیمتگذاری — مدیر مالی یا مالک کسبوکار: میتوانید سقف هزینهٔ جذب را بر پایهٔ ارزش عمر مشتری پس از ادغام تعیین کنید، نه عدد تکهتکه. AWS تصویر ناقص از ارزش عمر مشتری را یکی از پیامدهای پراکندگی هویت میداند[۱].
قدم اول: برای یک دستهٔ مشخص از مشتریان، ارزش عمر مشتری را با رکورد خام و با شناسهٔ یکپارچه حساب کنید و تصمیم بودجهٔ ماه بعد را با عدد دوم بگیرید.
زحمت: متوسط · حواستان باشد: این سنجه روی بازهٔ زمانی کوتاه گمراهکننده است. AWS هم میگوید تطبیق با دقت کامل روی دادهٔ واقعی عملی نیست و باید حد قابل قبول را از قبل تعیین کرد[۲].
یک خریدار، سه مشتری: مسئلهای که نامش تطبیق رکورد است
AWS میگوید تطبیق قطعی در واقعیت میشکند. تطبیق قطعی یعنی وصل کردن رکوردها از روی یک شناسهٔ واحد مثل ایمیل[۱]. یک خریدار برای خرید اینترنتی یک ایمیل دارد و برای باشگاه مشتریان ایمیل دیگری؛ در فروشگاه هم شمارهٔ دیگری میدهد[۱]. اعضای یک خانواده هم آدرس مشترک دارند[۱]. نتیجه دو خطا است که قرینهٔ هماند: دیدن یک مشتری به شکل چند نفر، یا چسباندن چند نفر به یک پروفایل[۱].
پراکندگی فقط در دادهٔ ثبتشده نیست. در یکی از نوشتههای AWS، با ارجاع به دادهٔ نقلشده از فوربز، آمده که حدود ۹۰ درصد ترافیک سایتها بازدیدکنندهٔ ناشناس است[۳]. هویت تازه وقتی پیدا میشود که کاربر وارد حساب شود یا خرید کند؛ از آن لحظه میتوان کلیکهای قبلی را به او نسبت داد[۳]. خرید مهمان و سفارش تلفنی هم همین اثر را دارند. سابقه وجود دارد، اما به یک نفر وصل نیست.
این مسئله نام خودش را دارد: تطبیق رکورد یا entity resolution، یعنی تشخیص اینکه چند رکورد به یک شخص واقعی مربوطاند. یک مرور پژوهشی، کارهای پایهای و مقالات کلیدی این حوزه را مرور میکند و ریشهٔ روشهای احتمالی امروزی را در همان کارهای قدیمی نشان میدهد[۶]. کاربردهایش از سرشماری تا تفکیک نام نویسندگان در پایگاههای مقاله است، یعنی جاهایی که شناسهٔ یکتا وجود ندارد[۶]. پس کمبود شما ابزار نیست؛ تصمیمنگرفتن دربارهٔ کلید هویت است.
چرا این خطا همیشه به سود بودجهٔ جذب تمام میشود
این خطا جهت دارد. تکه شدن یک مشتری تعداد مشتری یکتا را زیاد میکند و تعداد سفارش هر مشتری را کم. نرخ خرید دوباره — سهم مشتریانی که بیش از یک بار خرید کردهاند — پایینتر از واقعیت درمیآید. ارزش عمر مشتری هم همینطور. در عوض سهم مشتری تازه بزرگتر از واقعیت دیده میشود. مگر آنکه قاعدهٔ ادغام بیش از حد سخاوتمند باشد و چند نفر را یکی کند، هر سه انحراف در همین یک جهت میافتند.
بازندهٔ این خطا تیم نگهداشت و وفاداری است. وقتی عددها میگویند مشتری برنمیگردد، بحث بودجه تمام است و پول به کانالهای جذب میرود. برندهٔ آن هم هر کانالی است که با مشتری تازه سنجیده میشود، بدون اینکه کسی قصد فریب داشته باشد. مدل کسبوکاری که بیشتر آسیب میبیند، همان کسبوکار با خرید تکرارشدنی است: فروشگاه مواد مصرفی، خدمات دورهای، لوازم یدکی.
AWS میگوید با سرمایهگذاری شرکتها روی شخصیسازی مبتنی بر هوش مصنوعی، کیفیت دادهٔ پایهٔ مشتری به شرط اصلی تبدیل میشود[۱]. اثر درجهدومی که به نظر ما جدی است همینجاست. موتور پیشنهاد روی پروفایل تکهتکه، کالای خریدهشده را دوباره پیشنهاد میدهد و مشتری قدیمی را مثل غریبه خطاب میکند. مشتری این را احساس میکند و اثر آن در هیچ گزارش دادهای مستقیم دیده نمیشود.
یک هشدار هم دربارهٔ بزرگنمایی لازم است. عددی مثل کاهش ۴۳ درصدی رکوردهای تکراری که AWS از آزمون روی دادهٔ نمونه گزارش میکند، دربارهٔ رکورد است، نه درآمد[۱]. ادغام هویت به خودی خود فروش نمیسازد؛ فقط عدد درست را نشان میدهد و جای پول را عوض میکند.
قدمهای ارزان: کلید هویت، قاعدهٔ ادغام و یک نمونهٔ داوریشده
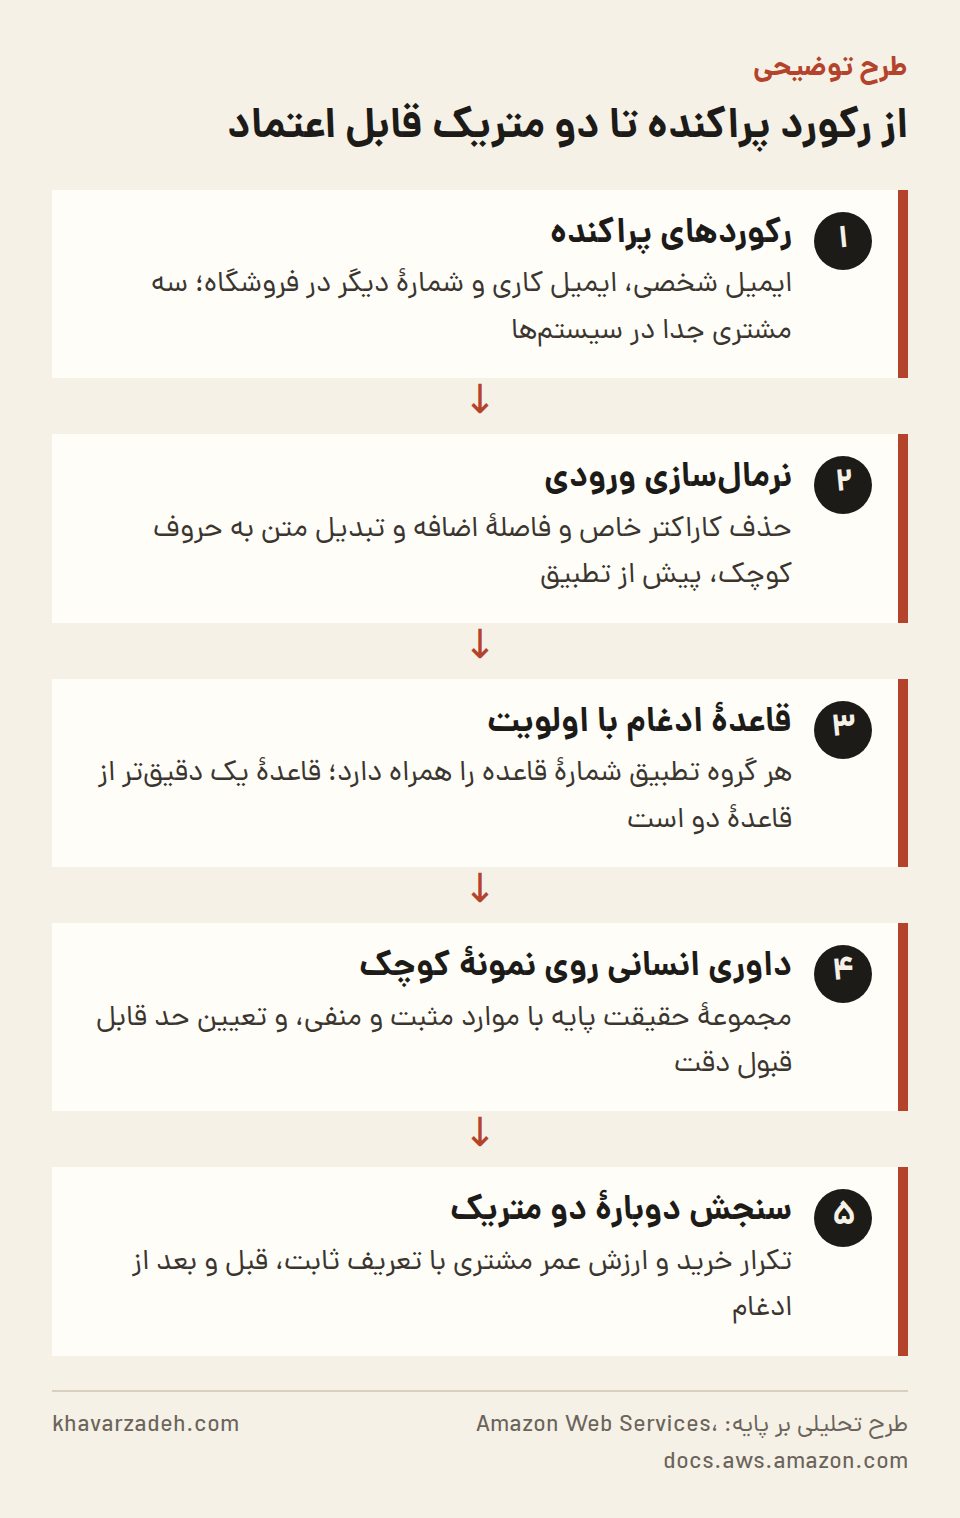
قدم اول نرمالسازی است، یعنی یکسان کردن شکل نوشتن داده. سرویس AWS Entity Resolution بهصورت پیشفرض ورودی را پیش از تطبیق نرمال میکند: حذف کاراکترهای خاص و فاصلهٔ اضافه و تبدیل متن به حروف کوچک[۵]. اگر دادهٔ شما از قبل نرمال است، میتوان این مرحله را خاموش کرد[۵]. همین کار در پایگاه دادهٔ خودتان هم شدنی است: یک ستون تازه برای شمارهٔ موبایل با یک قاعدهٔ ثابت، و یک ستون برای ایمیل با حروف کوچک.
قدم دوم قاعدهٔ ادغام با اولویت است. در تطبیق قاعدهمحور AWS هر گروه تطبیق، شمارهٔ قاعدهای را همراه دارد که با آن ساخته شده[۵]. ترتیب قاعدهها نشاندهندهٔ دقت است؛ قاعدهٔ یک دقیقتر از قاعدهٔ دو است[۵]. مدل یادگیری ماشین آمادهٔ همین سرویس از نام، ایمیل، شماره، آدرس و تاریخ تولد استفاده میکند[۵]. این مدل به هر گروه امتیاز اطمینان بین ۰٫۰ و ۱٫۰ میدهد[۵]. در ژوئن ۲۰۲۵ تطبیق قاعدهمحور نزدیک به زمان واقعی هم اضافه شد[۴]. رکورد تازه با رکوردهای موجود مقایسه میشود و در چند ثانیه یک شناسهٔ تطبیق ثابت برمیگردد[۴].
قدم سوم سنجش دقت است، چون ادغام بدون داوری به حدس تبدیل میشود. AWS پیشنهاد میکند مجموعهٔ حقیقت پایه بسازید[۲]. یعنی نمونهٔ کوچکی از جفت رکوردها که آدم به دست بررسی و برچسب زده باید ادغام شوند یا نه[۲]. این نمونه باید هم جفتهایی داشته باشد که باید یکی شوند و هم جفتهایی که شبیهاند ولی باید جدا بمانند[۲]. معیار متعارف F1 است که دقت و پوشش را با هم میسنجد[۲]. روی دادهٔ واقعی و حجم بزرگ، تطبیق با دقت کامل عملی نیست چون موارد مرزی واقعاً مبهماند[۲]. پس باید حد قابل قبول تعیین کنید، وگرنه پروژه هفتهها و ماهها کشیده میشود[۲]. سطح تطبیق هم تصمیم خودتان است. فروشگاه حضوری با کارت وفاداری مشترک و تلفن ثابت، در بهترین حالت به تطبیق در سطح خانوار میرسد[۲]. فروشگاه اینترنتی با ایمیل و آدرس تحویل میتواند در سطح فرد تطبیق دهد[۲].
قدم چهارم ساده است: همان دو متریک را با یک تعریف ثابت، قبل و بعد از ادغام دوباره بسنجید و اختلاف را به مدیریت گزارش کنید. ممکن است وسوسه شوید از خرید یک پلتفرم شروع کنید. IDC در گزارشی به تاریخ ژانویهٔ ۲۰۲۵ مینویسد بازار CDP متنوع است و خریداران تا حدی سردرگماند[۷]. CDP یا پلتفرم دادهٔ مشتری، سامانهای است که دادهٔ پراکندهٔ مشتری را یکپارچه و قابل استفاده میکند[۷]. به نوشتهٔ IDC انتخاب بین راهکار یکپارچه و راهکار ماژولار باز است و تیمهای داده و فناوری هم اتصال به انبار دادهٔ ابری، حریم خصوصی و حاکمیت داده را ارزیابی میکنند[۷]. به نظر ما ترتیب درست این است: اول کلید هویت و حد دقت، بعد انتخاب ابزار. بعد از ادغام، تقسیمبندی مشتریان و قضاوت دربارهٔ وفاداری مشتری روی عدد درست انجام میشود؛ همین دو موضوع میتواند خواندن بعدی شما روی همین سایت باشد.
| سنجه | مقدار گزارششده |
|---|---|
| رکوردهای منبع | ۱۳۹٬۲۲۸٬۶۵۱ |
| خوشههای مشتری یکتا پس از ادغام | ۷۹٬۷۰۸٬۹۹۲ |
| کاهش رکوردهای تکراری | ۴۳ درصد |
| رکوردهای ردهٔ شناختهشده پس از ادغام | ۸۳ درصد |
| رکوردهای نیمهشناخته که شناختهشده شدند | ۲۴٬۶۴۵٬۸۷۶ |
| زمان پاکسازی ناهنجاریها | حدود ۱۰ دقیقه |
| زمان یکپارچهسازی داده | کمی بیش از ۱۴ دقیقه |
خط زمانی
- 2025-01: IDC در یادداشتی دربارهٔ انتخاب پلتفرم دادهٔ مشتری مینویسد بازار CDP متنوع است و خریداران تا حدی سردرگماند.[۷]
- 2025-06: AWS تطبیق قاعدهمحور نزدیک به زمان واقعی را در Entity Resolution عرضه میکند؛ شناسهٔ تطبیق در چند ثانیه برمیگردد.[۴]
برای کسبوکارهای ایرانی
در بسیاری از فروشگاههای آنلاین و شرکتهای خدماتی ایرانی، شمارهٔ موبایل عملاً تنها شناسهٔ مشترک میان سفارش تلفنی، پیامک، حساب سایت و فاکتور است. این یک مشاهدهٔ کاری است، نه یافتهٔ منابع. اگر چنین باشد، انتخاب شمارهٔ موبایل نرمالشده به عنوان کلید هویت ارزانترین قدم است. به سرویس ابری بیرونی هم نیاز ندارد؛ همان منطق نرمالسازی و قاعدهٔ ادغام را میتوان با چند کوئری در پایگاه دادهٔ خودتان نوشت. دسترسی و پرداخت برای سرویسهایی مانند AWS Entity Resolution[۴][۵] برای کسبوکارهای ایرانی ساده نیست، اما روش کار قابل بازسازی است. یک نکتهٔ احتیاطی هم بماند: پروفایل یکپارچه دادههای بیشتری از یک نفر را یکجا جمع میکند، پس دسترسی به آن باید محدودتر از قبل باشد. IDC هم حریم خصوصی و حاکمیت داده را بخشی از ارزیابی این پلتفرمها میداند[۷].
چه چیزی را باید دنبال کرد
- آیا شناسهٔ تطبیق نزدیک به زمان واقعی به قابلیت استاندارد CRMها و باشگاههای مشتریان تبدیل میشود یا در سطح سرویسهای ابری بزرگ میماند[۴]
- آیا خریداران پلتفرم دادهٔ مشتری سنجش دقت با مجموعهٔ حقیقت پایه و F1 را به شرط خرید تبدیل میکنند یا به دمو بسنده میکنند[۲][۷]
- آیا ابزارهای ادغام هویت که روی زیرساخت خود شرکت اجرا میشوند و داده را بیرون نمیبرند گستردهتر میشوند[۱]
- اختلاف عدد تکرار خرید قبل و بعد از ادغام در گزارشهای داخلی خودتان: اندازهٔ همین اختلاف میگوید چقدر بودجه را اشتباه تقسیم کردهاید
منابع
- How retailers solve the customer identity puzzle with Amperity and AWS | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-10-05
- Measuring the accuracy of rule or ML-based matching in AWS Entity Resolution | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-10-05
- Create a 360-degree view of your consumers using AWS Entity Resolution and Amazon Neptune | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-10-05
- Near real-time matching available in AWS Entity Resolution - AWS — Amazon Web Services, Inc.، انتشار: 2025-06-03، شواهد تازه، دسترسی: 2026-10-05
- What is AWS Entity Resolution? — docs.aws.amazon.com، منبع مرجع، دسترسی: 2026-10-05
- (Almost) All of Entity Resolution — arxiv.org، منبع مرجع، دسترسی: 2026-10-05
- Choose a Customer Data Platform That Amplifies Your Customer Engagement Strategy — IDC، انتشار: 2025-01-13، مرجع پایه، دسترسی: 2026-10-05
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-05.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر