نقطهٔ سربهسر GPU و API: چرا بهرهوری سرور تصمیم را عوض میکند
هزینهٔ واقعی میزبانی مدل باز به نرخ درخواست بستگی دارد: روی H100 بین ۰٫۲۱ تا ۱۵٫۲۵ دلار برای هر میلیون توکن خروجی. راهنمای مقایسه با API.

فهرست مطالب
باید بین اجارهٔ سرور GPU و خرید از API یکی را انتخاب کنید؟ این تصمیم بیشتر از قیمت سختافزار به الگوی ترافیک شما بند است. مدیر مالی و مدیر محصول با یک محاسبهٔ ساده میتوانند چند ماه هزینهٔ بیبازده را حذف کنند. API یعنی درخواست را به سرور فروشنده میفرستید و فقط بهاندازهٔ مصرف پول میدهید. توکن هم واحد شمارش متن است، تقریباً تکهای از یک کلمه. اجارهٔ GPU ساعتی و ثابت است، اما ترافیک شما بالا و پایین میرود. اندازهگیریهای یک پژوهش مرجع روی سختافزار یکسان H100 نشان میدهد هزینهٔ مؤثر هر یک میلیون توکن خروجی از ۰٫۲۱ تا ۱۵٫۲۵ دلار تغییر میکند[۱]. پس عدد تعیینکننده قیمت ساعتی GPU نیست؛ درصد ساعتهایی است که آن GPU واقعاً توکن تولید میکند.
واقعیتهای کلیدی
- روی سختافزار یکسان H100، هزینهٔ مؤثر هر یک میلیون توکن خروجی بین ۰٫۲۱ تا ۱۵٫۲۵ دلار اندازهگیری شده است.[۱]
- جریمهٔ کمبهرهوری ۲٫۵ تا ۲۴ برابر در بارهای ۱ تا ۱۰ درخواست در ثانیه و تا ۳۶٫۳ برابر نزدیک حالت بیکاری گزارش شده است.[۱]
- بیش از ۹۰ درصد از بیش از ۱۵ ماشینحساب عمومی بررسیشده فقط نام مدل و تعداد توکن را ورودی میگیرند.[۱]
- پردازش دستهای ناهمزمان با ۵۰ درصد هزینهٔ کمتر و بازهٔ ۲۴ ساعته ارائه میشود.[۵][۴][۶]
- خواندن از کش پرامپت برای اکثر مدلهای Claude با ضریب ۰٫۱ قیمت پایهٔ توکن ورودی حساب میشود و عمر پیشفرض کش ۵ دقیقه است.[۳]
- قیمت رسیدن به عملکرد GPT-4 روی پرسشهای علمی سطح دکتری سالانه ۴۰ برابر افت کرده است.[۷]
کجای کسبوکار شما به کار میآید؟
مالی و قیمتگذاری — مدیر مالی یا مدیر فنی فروشگاه آنلاین: میتوانید پیش از هر خریدی هزینهٔ هر یک میلیون توکن را با ترافیک واقعی خودتان حساب کنید، نه با فرض بهرهوری کامل که ماشینحسابهای آماده میگذارند[۱]. همین محاسبه نشان میدهد ساعتهای خلوت چقدر بیبازده هستند.
قدم اول: یک ماه لاگ درخواستها را جمع کنید: تعداد درخواست در هر ساعت و توکن ورودی و خروجی هر درخواست؛ بعد اوج و کف ترافیک را جدا ببینید.
زحمت: کم · حواستان باشد: لاگ ناقص یا نبود شمارش توکن برآورد را خراب میکند و شمارش دقیق به کمی کدنویسی نیاز دارد.
عملیات و زنجیره تأمین — مسئول عملیات یا مدیر محتوا: میتوانید کارهای غیرفوری مانند تولید انبوه توضیح محصول، دستهبندی تیکتها و خلاصهسازی بازخورد مشتری را به پردازش دستهای ناهمزمان منتقل کنید که با ۵۰ درصد هزینهٔ کمتر ارائه میشود[۵][۴].
قدم اول: یک کار تکراری و بیعجله انتخاب کنید و همان را یک شب در قالب فایل دستهای اجرا کنید تا تفاوت صورتحساب را ببینید.
زحمت: متوسط · حواستان باشد: پاسخ تا ۲۴ ساعت طول میکشد[۵] و دسترسی و پرداخت این سرویسها برای کسبوکارهای ایرانی ساده نیست.
محصول و فناوری — مدیر محصول یا توسعهدهندهٔ چتبات: میتوانید پرامپت را طوری بچینید که بخش ثابت ابتدایی از کش خوانده شود؛ در مستندات Claude خواندن از کش برای اکثر مدلها با ضریب ۰٫۱ قیمت پایهٔ ورودی حساب میشود[۳].
قدم اول: پرامپت فعلی را دو تکه کنید: بخش ثابت شامل دستور، نمونهها و اطلاعات پایه در ابتدا، و بخش متغیر هر کاربر در انتها.
زحمت: کم · حواستان باشد: عمر پیشفرض کش ۵ دقیقه است[۳]، پس برای ترافیک پراکنده سود کمی دارد و نوشتن در کش گرانتر از ورودی معمولی است.
مدیریت و تصمیمگیری — مدیرعامل یا مدیر فناوری شرکت خدماتی: میتوانید هر تعهد بلندمدت به سختافزار یا ظرفیت رزرو را به یک آستانهٔ بهرهوری گره بزنید و فصلی بازبینی کنید، چون قیمت رسیدن به یک سطح عملکرد مشخص روند نزولی داشته است[۷].
قدم اول: یک بازبینی سهماهه در تقویم بگذارید و در آن فقط دو عدد را مقایسه کنید: هزینهٔ واقعی هر میلیون توکن خودتان و قیمت روز سرویسهای جایگزین.
زحمت: کم · حواستان باشد: افت قیمت گذشته تضمین آینده نیست؛ خود Epoch AI میگوید تداوم سریعترین افتها روشن نیست[۷].
هزینهٔ هر میلیون توکن روی یک GPU ثابت نیست
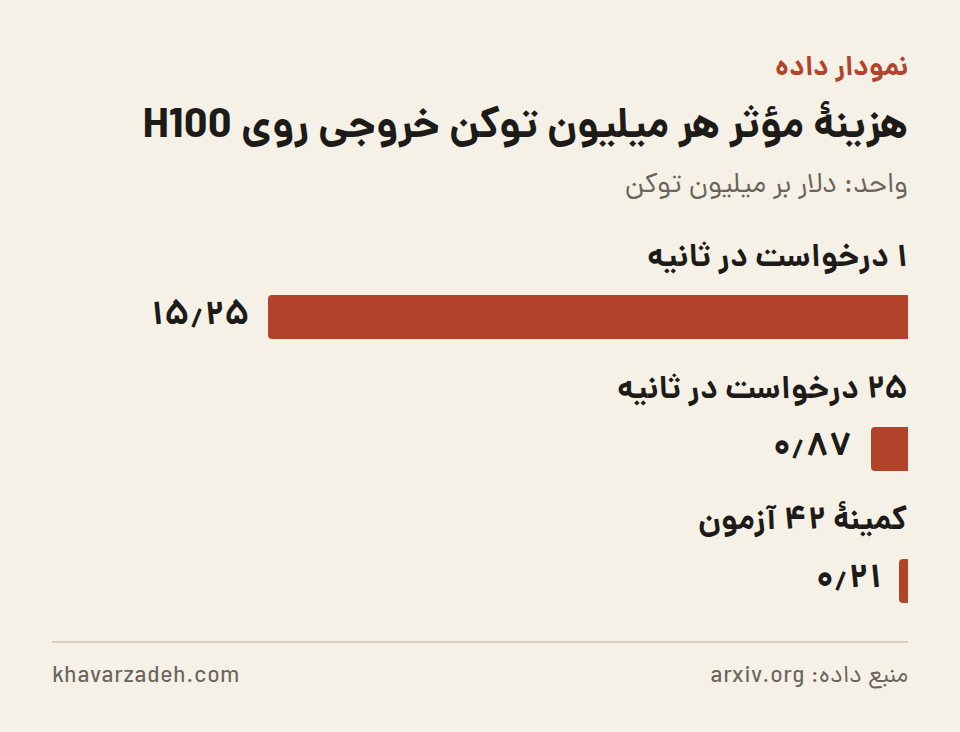
یک پژوهش مرجع سرورهای زندهٔ vLLM را اندازه گرفته است؛ vLLM نرمافزاری متنباز برای سرو کردن مدلهای زبانی است[۱]. روی H100، در نرخ ۱ درخواست در ثانیه، استقرار Mixtral 8x7B با دقت FP16 برای هر یک میلیون توکن ۱۵٫۲۵ دلار تمام میشود[۱]. در ۲۵ درخواست در ثانیه، همان سختافزار ۰٫۸۷ دلار هزینه دارد[۱]. پژوهش این فاصله را نسبتی ۱۷٫۵ برابری میان بار کم و اشباع میخواند[۱]. نرخ درخواست در ثانیه یعنی چند درخواست در هر ثانیه به سرور میرسد. نویسندگان دامنهٔ جریمهٔ کمبهرهوری را ۲٫۵ تا ۲۴ برابر در بارهای ۱ تا ۱۰ درخواست در ثانیه و تا ۳۶٫۳ برابر نزدیک حالت بیکاری گزارش میکنند[۱]. پایهٔ این اعداد ۴۲ آزمون روی H100 است[۱]. تکرار همان سنجش روی A100 80GB PCIe با ۵۶ اجرا دامنهای ۷٫۰ تا ۱۱٫۴ برابری داده است[۱].
دلیل غایب بودن این عدد در تصمیمها، ابزارهاست. به گزارش همین پژوهش، در بررسی بیش از ۱۵ ماشینحساب عمومی هزینهٔ مدلهای زبانی، بیش از ۹۰ درصد آنها فقط نام مدل و تعداد توکن را ورودی میگیرند[۱]. یک تحلیل دانشگاهی بهرهوری کامل را در ۱۶۰ ساعت کاری ماه فرض کرده و چارچوبی دیگر ۸۰ درصد[۱]. به گزارش این پژوهش، برآوردهای غافل از بهرهوری هزینه را کمتر از واقع نشان میدهند[۱]. بیشترین خطا هم برای بارهای کمترافیک رخ میدهد؛ یعنی جایی که میزبانی خودتان بیش از حد جذاب جلوه میکند[۱]. اهل فن هم همین را کیفی دیده بودند: یک GPU در ۱۰ درصد بار، هزینهٔ ۱۳ دلار برای هر میلیون توکن را به ۱۳۰ دلار تبدیل میکند[۱].
سه اهرم ارزانتر از خرید سختافزار
اول، پردازش دستهای ناهمزمان؛ یعنی درخواستها را یکجا میفرستید و پاسخ را دیرتر میگیرید. مستندات OpenAI با تاریخ ۸ سپتامبر ۲۰۲۶ میگوید Batch API با ۵۰ درصد هزینهٔ کمتر، سهمیهٔ نرخ بالاتر و بازهٔ مشخص ۲۴ ساعته کار میکند[۵]. مستندات قدیمیتر Anthropic با تاریخ ۲۴ سپتامبر ۲۰۲۴ همان ۵۰ درصد را برای Message Batches API ذکر میکند[۴]. به همان مستندات، بیشتر دستهها زیر ۱ ساعت تمام میشوند و سقف هر دسته ۱۰۰٬۰۰۰ درخواست یا ۲۵۶ مگابایت است[۴]. در صفحهٔ قیمت Amazon Bedrock هم استنتاج دستهای ۵۰ درصد ارزانتر از حالت درخواستی اعلام شده است[۶].
دوم، کش پرامپت. پرامپت همان متن دستوری است که به مدل میدهید و کش یعنی بخش ثابت ابتدای آن یک بار پردازش و نگه داشته شود. به مستندات Claude، خواندن از کش برای اکثر مدلها با ضریب ۰٫۱ قیمت پایهٔ توکن ورودی حساب میشود و برای چند مدل این ضریب ۰٫۰۲۵ یا ۰٫۰۵ است[۳]. نوشتن در کش از ورودی معمولی گرانتر است و عمر پیشفرض کش ۵ دقیقه است[۳]. نسخهٔ یکساعته هم ۲ برابر قیمت پایهٔ ورودی حساب میشود[۳]. این اهرم فقط وقتی جواب میدهد که درخواستها پشت سر هم و با مقدمهٔ یکسان برسند[۳].
سوم، شکل درخواست. یک پژوهش مرجع دیگر مصرف انرژی را تفکیک کرده است: هر درخواست یک هزینهٔ ثابت دارد و بعد هر توکن خروجی هزینهٔ نهایی خودش را اضافه میکند[۲]. اندازهگیری روی Llama-3.2-1B و GPU مدل H200 را ببینید، با دستهٔ ۱۶ و متن ورودی ۴K توکنی[۲]. وقتی طول خروجی از ۱۰ به ۵۱۲ توکن میرسد، انرژی هر توکن از ۷٫۴۶ به ۰٫۷۲ ژول پایین میآید[۲]. اما انرژی کل همان پنجرهٔ پردازش از ۱٫۱۹ به ۵٫۹۳ کیلوژول بالا میرود[۲]. سود دستهبندی هم به طول متن ورودی بند است: در خروجی ۱۰ توکنی، برتری دستهٔ ۱۶ بر دستهٔ ۱ از ۶٫۳۱ برابر در متن ۵۱۲ توکنی به ۱٫۱۷ برابر در متن ۴K توکنی میافتد[۲]. این اندازهگیری دربارهٔ انرژی است نه صورتحساب دلاری، اما همان ساختار هزینهٔ ثابت بهازای هر درخواست را نشان میدهد[۲].
قیمت توکن پایین آمده و تعهد بلندمدت را ریسکی میکند
سمت دیگر معادله هم ثابت نمیماند. بنچمارک یعنی آزمون استاندارد برای سنجش توانایی مدل. Epoch AI با نگاه به نتایج مدلهای پیشرو روی ۶ بنچمارک در سه سال، قیمت رسیدن به یک سطح عملکرد مشخص را اندازه گرفته است[۷]. به گزارش این تحلیل، قیمت رسیدن به عملکرد GPT-4 روی مجموعهای از پرسشهای علمی سطح دکتری سالانه ۴۰ برابر افت کرده است[۷]. نرخ این افت بسته به سطح عملکرد بین ۹ تا ۹۰۰ برابر در سال بوده است[۷]. در جدول همین تحلیل، GPT-4-0314 در مارس ۲۰۲۳ با ۳۷٫۵۰ دلار برای هر یک میلیون توکن ثبت شده است[۷]. در همان سطح نمرهٔ MMLU، Gemini 2.0 Flash در فوریهٔ ۲۰۲۵ با ۰٫۱۸ دلار ثبت شده است[۷]. خود Epoch AI هشدار میدهد سریعترین افتها در پایان دورهٔ بررسی رخ داده و روشن نیست ادامه پیدا کنند[۷].
تصمیم عملی: اول آستانه، بعد سختافزار
از این شواهد یک ترتیب کار بیرون میآید. پیش از گرفتن قیمت سرور، چند عدد خودتان را بنویسید: حجم توکن ماهانه، نسبت توکن ورودی به خروجی، نمودار ساعتی ترافیک در یک ماه، و سهمی از بار که میتواند شبانه و دستهای اجرا شود. عدد آخر همان ضریب بهرهوری است. اگر سرور را تمام ماه اجاره کنید و بار واقعی فقط چند ساعت اوج داشته باشد، بقیهٔ ساعتها هم پول میدهید و هم توکنی تولید نمیشود. به نظر ما برای کسبوکارهایی با ترافیک کم و پراکنده، خرید از API تقریباً همیشه ارزانتر در میآید. تخفیف دستهای و کش این فاصله را بیشتر هم میکند.
هزینههای پنهان را هم باید در همان جدول آورد: نگهداری سرور، نوبتکاری برای پایداری، ساخت مجموعهٔ ارزیابی برای سنجش کیفیت پاسخها، و تکرار همین کار در هر ارتقای نسخهٔ مدل. یک اثر دوم هم برداشت ماست. قیمت API روند نزولی داشته است[۷]. پس هر تعهد سختافزاری یا رزرو ظرفیت چندماهه میتواند شما را روی قیمتی قفل کند که چند ماه بعد گران به نظر برسد. در مقابل، در بارهای اشباع هزینهٔ میزبانی خودتان واقعاً پایین میآید[۱]. پس حرف درست این نیست که میزبانی همیشه گرانتر است، بلکه این است که زیر یک آستانهٔ مصرف گرانتر است.
دلایل غیرهزینهای جای خودشان را دارند: ماندن داده در داخل سازمان، پایداری دسترسی و استقلال از تغییر قیمت فروشنده. فقط بهتر است اینها را صرفهجویی ننامیم؛ بهای کنترل هستند و باید آگاهانه پرداخت شوند. یک محدودیت هم بماند: اعداد این پژوهشها برای مدلها، سختافزارها و بارهای مشخص اندازهگیری شدهاند[۱][۲]. این اعداد جای محاسبه با ترافیک خودتان را نمیگیرند. قدم بعدی روشن است: یک ماه لاگ مصرف جمع کنید و همین چند عدد را برای کسبوکار خودتان بنویسید.
| گزینه | هزینهٔ هر ۱ میلیون توکن (دلار) | توضیح | منبع |
|---|---|---|---|
| میزبانی خودتان، H100، Mixtral 8x7B FP16، ۱ درخواست در ثانیه | ۱۵٫۲۵ (خروجی) | هزینهٔ مؤثر اندازهگیریشده در بار کم | S1 |
| همان مدل و سختافزار در ۲۵ درخواست در ثانیه | ۰٫۸۷ (خروجی) | نسبت ۱۷٫۵ برابری با حالت کمبار | S1 |
| کمینهٔ هزینهٔ مؤثر در ۴۲ آزمون روی H100 | ۰٫۲۱ (خروجی) | سقف بهرهوری | S1 |
| DeepSeek v3.2 روی Bedrock، مناطق آمریکا | ۰٫۶۲ ورودی / ۱٫۸۵ خروجی | قیمت درخواستی استاندارد | S6 |
| Mistral Large 3 روی Bedrock، مناطق آمریکا | ۰٫۵۰ ورودی / ۱٫۵۰ خروجی | قیمت درخواستی استاندارد | S6 |
| Gemma 3 27B روی Bedrock، مناطق آمریکا | ۰٫۲۳ ورودی / ۰٫۳۸ خروجی | قیمت درخواستی استاندارد | S6 |
| ظرفیت رزرو Llama 2 (13B) با تعهد یکماهه | — | ۲۱٫۱۸ دلار در ساعت برای هر model unit | S6 |
خط زمانی
- 2023-03-14: GPT-4-0314 با ۳۷٫۵۰ دلار برای هر یک میلیون توکن و نمرهٔ ۸۶ در MMLU ثبت شده است.[۷]
- 2024-05-13: GPT-4o با ۷٫۵۰ دلار برای هر یک میلیون توکن در همان سطح نمرهٔ MMLU ثبت شده است.[۷]
- 2024-09-24: مستندات Anthropic پردازش دستهای با ۵۰ درصد قیمت استاندارد و سقف ۱۰۰٬۰۰۰ درخواست در هر دسته را توضیح میدهد.[۴]
- 2025-02-05: Gemini 2.0 Flash با ۰٫۱۸ دلار برای هر یک میلیون توکن و نمرهٔ ۸۸ در MMLU ثبت شده است.[۷]
- 2026-09-08: مستندات OpenAI دربارهٔ Batch API: ۵۰ درصد هزینهٔ کمتر، سهمیهٔ نرخ بالاتر و بازهٔ ۲۴ ساعته.[۵]
برای کسبوکارهای ایرانی
برای کسبوکارهای ایرانی دو نکتهٔ عملی میماند. اول، تخفیف دستهای و کش پرامپت روی سرویسهای خارجی ارائه میشوند[۵][۳] و دسترسی و پرداخت برای همه ساده نیست. اگر این دو اهرم در دسترس نباشد، مقایسه به قیمت نقدی API در برابر اجارهٔ GPU محدود میشود و به نظر میرسد نتیجه زودتر به سمت میزبانی داخلی برود. دوم، مدلهای با وزن باز (open-weight)، یعنی مدلهایی که فایل وزنهایشان در دسترس است، روی سختافزار داخلی یا اجارهای اجرا میشوند. این برای ماندن داده در داخل و پایداری دسترسی ارزش دارد. برداشت ما این است که بهتر است همان ضریب بهرهوری را حساب کنید و تفاوت هزینه را آگاهانه بهعنوان بهای کنترل بپردازید، نه با فرض صرفهجویی.
چه چیزی را باید دنبال کرد
- ضریب بهرهوری خودتان را ماهانه اندازه بگیرید: چند درصد ساعتهای اجارهشده واقعاً توکن تولید کرده است.
- سهم بار قابلتبدیل به دستهای ناهمزمان را مشخص کنید؛ تخفیف ۵۰ درصدی فقط به کارهای بیعجله میخورد[۵].
- قیمت توکن مدلهای میانی روی سرویسهای ابری را فصلی بازبینی کنید، چون روند قیمت نزولی بوده است[۷].
- ابزارهای اندازهگیری هزینه روی سرور زنده، مثل متر هزینهٔ vLLM که همان پژوهش منتشر کرده، را بررسی کنید[۱].
دادههای مرتبط در همین سایت: تورم سالانه قیمت مصرفکننده: آمریکا و میانگین OECD
منابع
- Beyond Per-Token Pricing: A Concurrency-Aware Methodology for LLM Infrastructure Cost Estimation — arxiv.org، منبع مرجع، دسترسی: 2026-10-05
- Characterization of Request and Token Energy Costs for LLM Inference Workloads on GPU Platforms — arxiv.org، منبع مرجع، دسترسی: 2026-10-05
- Prompt caching — Claude Platform Docs، منبع مرجع، دسترسی: 2026-10-03
- Batch processing — Claude Platform Docs، انتشار: 2024-09-24، مرجع پایه، دسترسی: 2026-10-05
- Batch API | OpenAI API — OpenAI Developers، انتشار: 2026-09-08، شواهد تازه، دسترسی: 2026-10-05
- Amazon Bedrock Pricing – AWS — Amazon Web Services, Inc.، منبع مرجع، دسترسی: 2026-10-05
- LLM inference prices have fallen rapidly but unequally across tasks — Epoch AI، منبع مرجع، دسترسی: 2026-10-02
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-05.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر