تعداد لایسنس معیار پذیرش نیست: استفاده واقعی از هوش مصنوعی را در سطح وظیفه بسنجید
دادههای استنفورد، مایکروسافت، Anthropic، IBM و MIT نشان میدهد آمار پذیرش هوش مصنوعی عمق استفاده و Shadow AI را پنهان میکند؛ چارچوبی سهلایه برای سنجش.
فهرست مطالب
آمار کلان پذیرش هوش مصنوعی بالاست. طبق گزارش شاخص هوش مصنوعی ۲۰۲۵ دانشگاه استنفورد، ۷۸ درصد سازمانها گفتهاند که در سال ۲۰۲۴ از هوش مصنوعی استفاده کردهاند و این رقم در سال پیش از آن ۵۵ درصد بود[۴]. گزارش Work Trend Index مایکروسافت درباره سال ۲۰۲۴ هم نشان داده بود که ۷۵ درصد دانشکاران جهان از هوش مصنوعی مولد استفاده میکردند[۲]. اما وقتی همین پدیده در سطح وظیفه و نتیجه کسبوکار سنجیده شود، تصویر دیگری به دست میآید. برداشت ما این است که پرسش اصلی مدیر این نیست که چند نفر به ابزار دسترسی دارند. پرسش اصلی این است که کدام گامهای کار واقعاً به مدل سپرده شده، خروجی فرایند چه تغییری کرده و چه بخشی از کار بیرون از دید سازمان و در ابزارهای شخصی انجام میشود.
واقعیتهای کلیدی
- طبق شاخص هوش مصنوعی ۲۰۲۵ استنفورد، ۷۸ درصد سازمانها در سال ۲۰۲۴ استفاده از هوش مصنوعی را گزارش کردند؛ این رقم سال پیش از آن ۵۵ درصد بود.[۴]
- طبق شاخص اقتصادی Anthropic، حدود ۳۶ درصد مشاغل دستکم در یکچهارم وظایف و فقط حدود ۴ درصد در سهچهارم وظایف از هوش مصنوعی استفاده میکنند.[۵]
- طبق گزارش MIT NANDA، فقط حدود ۵ درصد پایلوتهای هوش مصنوعی مولد درآمد را بهسرعت افزایش دادهاند.[۶]
- در سازمانهایی که Shadow AI در آنها زیاد بود، هزینه نشت داده ۶۷۰٬۰۰۰ دلار بیشتر از میانگین جهانی بود.[۱]
- ۶۳ درصد از ۶۰۰ سازمان بررسیشده هیچ سیاستی برای حاکمیت هوش مصنوعی نداشتند.[۱]
- پاسخهای نظرسنجی Work Trend Index 2026 خوداظهاریاند و داده رفتاری در آنها به کار نرفته است.[۳]
آمار پذیرش بالاست، اما استفاده در سطح وظیفه عمق کمی دارد
شاخص اقتصادی Anthropic به جای نظرسنجی، حدود ۱ میلیون گفتگو در Claude.ai را تحلیل کرده است[۵]. در این تحلیل هر گفتگو به یکی از وظایف پایگاه O*NET نسبت داده شده؛ پایگاهی که حدود ۲۰٬۰۰۰ وظیفه شغلی را فهرست میکند[۵]. طبق نتایج، حدود ۳۶ درصد مشاغل دستکم در یکچهارم وظایفشان از هوش مصنوعی استفاده میکنند، اما این نسبت در سهچهارم وظایف فقط به حدود ۴ درصد مشاغل میرسد[۵]. بیشترین استفاده به توسعه نرمافزار و نگارش فنی مربوط است[۵]. همچنین در ۵۷ درصد وظایف هوش مصنوعی به کمک کار انسان آمده و ۴۳ درصد وظایف خودکار شدهاند[۵].
خود Anthropic به محدودیت این دادهها اشاره کرده است[۵]. نمیتوان مطمئن بود که کاربر برای کار از Claude استفاده کرده و نیز معلوم نیست با پاسخ مدل چه کرده است[۵]. این دادهها فقط از پلنهای Free و Pro آمدهاند و به گفته Anthropic نماینده کل استفاده از هوش مصنوعی نیستند[۵]. به نظر میرسد حتی داده رفتاری در سطح وظیفه فقط نشان میدهد مدل کجا به کار رفته است، نه اینکه خروجی فرایند چه تغییری کرده است.
فورچن در اوت ۲۰۲۵ گزارش The GenAI Divide را پوشش داد که ابتکار NANDA در MIT منتشر کرده بود[۶]. طبق این گزارش، فقط حدود ۵ درصد پایلوتهای هوش مصنوعی مولد درآمد را بهسرعت افزایش دادهاند و بیشتر آنها اثر قابلاندازهگیری بر سود و زیان نداشتهاند[۶]. نتایج بر پایه ۱۵۰ مصاحبه با مدیران، نظرسنجی از ۳۵۰ کارمند و تحلیل ۳۰۰ استقرار عمومی به دست آمده است[۶]. به گفته نویسنده اصلی گزارش، مشکل از کیفیت مدل نیست، بلکه ابزارهای عمومی از جریان کار سازمان یاد نمیگیرند و خود را با آن تطبیق نمیدهند[۶]. برداشت ما این است که تیتری که از نرخ شکست ۹۵ درصدی سخن میگوید بیش از حد کلی است، چون معیار گزارش افزایش سریع درآمد است[۶].
کاری که در داشبورد لایسنس دیده نمیشود
گزارش Work Trend Index مایکروسافت درباره ۲۰۲۴ نشان داده بود که کارکنان همه گروههای سنی ابزارهای هوش مصنوعی شخصی خود را سر کار میآورند[۲]. طبق همان گزارش، فقط ۳۹ درصد کسانی که در کار از هوش مصنوعی استفاده میکنند از شرکت خود آموزش گرفته بودند[۲]. گزارش MIT هم از استفاده گسترده از ابزارهای تأییدنشدهای مانند ChatGPT خبر داده است؛ پدیدهای که Shadow AI نامیده میشود[۶].
گزارش ۲۰۲۵ IBM درباره هزینه نشت داده، هزینه این پدیده را با عدد نشان میدهد[۱]. مؤسسه مستقل Ponemon برای این گزارش ۶۰۰ سازمان را بررسی کرده و ۶۳ درصد آنها هیچ سیاستی برای حاکمیت هوش مصنوعی یا جلوگیری از Shadow AI نداشتند[۱]. طبق همین گزارش، در سازمانهایی که Shadow AI در آنها زیاد بود، هزینه نشت داده ۶۷۰٬۰۰۰ دلار بیشتر از میانگین جهانی بود[۱]. همچنین ۹۷ درصد سازمانهایی که حادثه امنیتی مرتبط با هوش مصنوعی داشتند، کنترل دسترسی مناسبی برای هوش مصنوعی نداشتند[۱].
طبق گزارش MIT، بیش از نیمی از بودجه هوش مصنوعی مولد صرف ابزارهای فروش و بازاریابی میشود، در حالی که بیشترین بازده در خودکارسازی کارهای پشتیبانی داخلی دیده شده است[۶]. به نظر میرسد داشبورد لایسنس استفاده از حسابهای شخصی را نمیبیند و در نتیجه تیمی که بخش بزرگی از کارش را با ابزارهای بیرونی انجام میدهد، ممکن است کممصرف به نظر برسد. همچنین میتواند چنین باشد که وقتی تعداد کاربر فعال معیار موفقیت است، ابزارهایی که بیشتر به چشم میآیند بودجه بیشتری بگیرند و ابزارهایی که هزینهای را از فرایند حذف میکنند سهم کمتری بگیرند.
حتی پژوهشهای بزرگ اثر را از زبان خود کاربران میسنجند
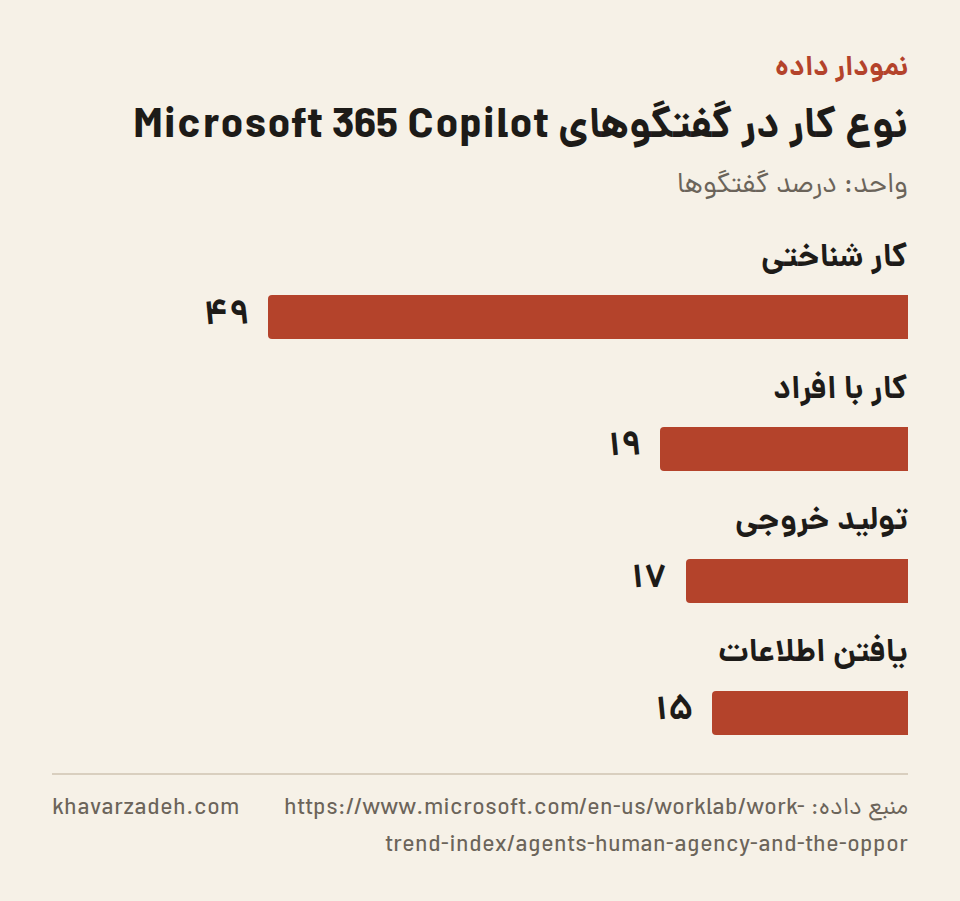
گزارش Work Trend Index 2026 مایکروسافت نمونهای از سنجش در سطح وظیفه ارائه میکند[۳]. این گزارش بیش از ۱۰۰٬۰۰۰ گفتگو در Microsoft 365 Copilot را تحلیل کرده است[۳]. طبق نتایج، ۴۹ درصد گفتگوها به کار شناختی مانند تحلیل و حل مسئله مربوط بودهاند[۳]. بقیه به کار با افراد (۱۹ درصد)، تولید خروجی (۱۷ درصد) و یافتن اطلاعات (۱۵ درصد) تعلق داشتهاند[۳]. همین گزارش میگوید سهم عوامل سازمانی مانند فرهنگ، حمایت مدیر و شیوههای مدیریت استعداد در اثر گزارششده هوش مصنوعی، دو برابر سهم تلاش فردی است[۳].
بخش نظرسنجی این گزارش بر پایه پاسخ ۲۰٬۰۰۰ کاربر در ۱۰ کشور است که از ۱۸ فوریه تا ۲۰ آوریل ۲۰۲۶ اجرا شده است[۳]. خود گزارش تصریح میکند که این پاسخها خوداظهاریاند و هیچ داده رفتاری در آنها به کار نرفته است[۳]. طبق نتایج، فقط ۱۹ درصد کاربران در گروه پیشرو (Frontier) قرار دارند و حدود نیمی از کارکنان در منطقه میانیاند[۳]. برداشت ما این است که وقتی حتی چنین پژوهش بزرگی اثر را با پاسخ خود کاربران میسنجد، داشبورد خرید نرمافزار بهتنهایی نمیتواند تصویر درستی بدهد.
سه لایه سنجش و تغییرهایی که هر تیم باید بدهد
پیشنهاد ما چارچوبی سهلایه است. لایه اول دسترسی است: لایسنس، کاربر فعال و دفعات ورود. سنجش این لایه ارزان و لازم است، اما فقط ظرفیت را نشان میدهد. لایه دوم استفاده در وظیفه است. برای هر فرایند کلیدی فهرستی از گامهای تکراری تهیه میشود. سپس با نمونهبرداری از لاگها، یا اگر لاگی نیست با نظرسنجی کوتاه و بدون سرزنش، مشخص میشود کدام گام به مدل سپرده شده و با چه ابزاری، از جمله ابزارهای شخصی. لایه سوم تغییر در خروجی فرایند است: زمان انجام کار، حجم دوبارهکاری، نرخ خطا و هزینههایی که پرداخت به طرفهای بیرونی را کاهش دادهاند.
برای تیم داده، این چارچوب یعنی اتصال لاگ ابزارها به نقشه فرایندها، نه ساختن یک داشبورد مصرف دیگر. تیم محصول و بازاریابی میتواند به جای شمردن محتوایی که با هوش مصنوعی تولید شده، اثر آن را بر زمان انتشار یا نرخ بازنویسی بسنجد. مدیران مالی هم احتمالاً اگر تمدید قراردادها را به نتایج لایه سوم وابسته کنند، تصمیم دقیقتری میگیرند. در مقابل، فروشندگانی که ارزش محصولشان را با تعداد کاربران توضیح میدهند ممکن است زیر فشار قرار بگیرند.
یک پیامد غیرمستقیم محتمل این است که وقتی استفاده از ابزارهای شخصی شفاف شود، سازمان به جای ممنوع کردن آن، برای همان وظایف ابزار رسمی فراهم کند. در این حالت Shadow AI میتواند به دادهای برای اولویتبندی خرید تبدیل شود. این چارچوب محدودیت هم دارد. نتایج لایه سوم دیر به دست میآید و به وضعیت پیش از استقرار برای مقایسه نیاز دارد. جدا کردن اثر هوش مصنوعی از تغییرهایی که همزمان در سازمان رخ میدهد نیز دشوار است.
| شاخص | مقدار | منبع و جامعه آماری |
|---|---|---|
| سازمانهایی که در سال ۲۰۲۴ استفاده از هوش مصنوعی را گزارش کردند | ۷۸ درصد | شاخص هوش مصنوعی ۲۰۲۵ استنفورد |
| دانشکارانی که از هوش مصنوعی مولد استفاده میکنند | ۷۵ درصد | Work Trend Index مایکروسافت، ۲۰۲۴ |
| کاربرانی که از شرکت خود آموزش هوش مصنوعی گرفتهاند | ۳۹ درصد | Work Trend Index مایکروسافت، ۲۰۲۴ |
| مشاغلی که دستکم در یکچهارم وظایف از هوش مصنوعی استفاده میکنند | ۳۶ درصد | شاخص اقتصادی Anthropic، گفتگوهای Claude.ai |
| مشاغلی که در سهچهارم وظایف از هوش مصنوعی استفاده میکنند | ۴ درصد | شاخص اقتصادی Anthropic، گفتگوهای Claude.ai |
| پایلوتهایی که درآمد را بهسرعت افزایش دادهاند | ۵ درصد | MIT NANDA به نقل از فورچن |
خط زمانی
- 2025-08-18: فورچن گزارش The GenAI Divide از ابتکار NANDA در MIT را درباره نتایج پایلوتهای هوش مصنوعی مولد پوشش داد[۶]
- 2026-04-20: پایان اجرای نظرسنجی Work Trend Index 2026 مایکروسافت با ۲۰٬۰۰۰ پاسخدهنده در ۱۰ کشور[۳]
برای کسبوکارهای ایرانی
در تیمهایی که همزمان با ابزارهای رسمی، مدلهای متنباز و حسابهای شخصی کار میکنند، احتمالاً لایه دوم این چارچوب اهمیت بیشتری دارد؛ چون تعداد لایسنسها فقط بخشی از استفاده واقعی را نشان میدهد. نمونهبرداری از وظایف و پرسیدن منظم درباره ابزارهای مورد استفاده هزینه زیادی ندارد. این کار میتواند نشان دهد داده مشتری یا کد سازمان کجا وارد سرویسهایی میشود که سازمان بر آنها کنترلی ندارد.
چه چیزی را باید دنبال کرد
- آیا نسخههای بعدی Work Trend Index، علاوه بر خوداظهاری کاربران، اثر هوش مصنوعی را با دادههای رفتاری هم میسنجند؟
- تکرار تحلیلهای شاخص اقتصادی Anthropic و تغییر سهم خودکارسازی در برابر کمک به کار انسان
- دادههای تازه درباره هزینه Shadow AI در گزارشهای بعدی نشت داده
- فشار خریداران برای قیمتگذاری ابزارهای هوش مصنوعی بر اساس نتیجه به جای تعداد کاربر
بیشتر بخوانید: هوش مصنوعی در برنامه نویسی
منابع
- 2025 Cost of a Data Breach Report: Navigating the AI rush without sidelining security | IBM — 2025 Cost Of A Data Breach Report: Navigating The Ai Rush Without Sidelining Security، منبع مرجع، دسترسی: 2026-09-17
- AI at Work Is Here. Now Comes the Hard Part — https://www.microsoft.com/en-us/worklab/work-trend-index/ai-at-work-is-here-now-comes-the-hard-part، منبع مرجع، دسترسی: 2026-09-17
- 2026 Work Trend Index report: Agents, human agency, and opportunity — https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization، منبع مرجع، دسترسی: 2026-09-17
- The 2025 AI Index Report — hai.stanford.edu، منبع مرجع، دسترسی: 2026-09-16
- Introducing the Anthropic Economic Index — AnthropicAI، منبع مرجع، دسترسی: 2026-09-16
- MIT report: 95% of generative AI pilots at companies are failing | Fortune — Fortune، انتشار: 2025-08-18، شواهد تازه، دسترسی: 2026-09-17
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-17.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر