هوش مصنوعی سایه سیگنال تقاضاست: چه چیزی را ببندیم و چه چیزی را رسمی کنیم
هوش مصنوعی سایه با مسدودکردن دامنه از بین نمیرود؛ کشف، کنترل خروج داده در مرورگر و endpoint و تحلیل لاگها تعیین میکند کدام کاربرد باید رسمی شود.
فهرست مطالب
وقتی سازمان دسترسی به ابزارهای عمومی هوش مصنوعی را روی دستگاههای کاری میبندد، معمولاً مصرف را حذف نمیکند؛ آن را به لپتاپ و گوشی شخصی منتقل میکند، جایی که هیچ لاگی باقی نمیماند. تحلیل تازهٔ هاروارد بیزینس ریویو میگوید بسیاری از برنامههای هوش مصنوعی مولد شرکتی با ابزارهای دستوپاگیر، استقرار کند و نتایج ناچیز شکست میخورند و کارکنان بهجای آنها، بیاطلاع واحد فناوری اطلاعات و انطباق، سراغ نسخههای شخصی ChatGPT و Claude میروند[۴]. در همان تحلیل، مقامی در یک بانک مرکزی بزرگ توصیف کرده است که کارکنان هنگام کار با رایانههای امن و بدون هوش مصنوعیِ بانک، لپتاپ شخصیشان را روی صفحهٔ اول مدل زبانی موردعلاقهشان باز نگه میدارند[۴]. پرسش درست برای مدیر، طول فهرست دامنههای مسدودشده نیست؛ ترتیب کارهاست: اول دیدن، بعد تصمیم دربارهٔ اینکه چه چیزی رسمی و بودجهدار شود و چه چیزی واقعاً باید متوقف بماند.
واقعیتهای کلیدی
- مستندات Microsoft Learn برای جلوگیری از نشت داده به هوش مصنوعی سایه چهار گام دارد و گام نخست، کشف و پایش است پیش از هر اقدام مسدودکننده.[۱]
- Defender for Cloud Apps برای هر اپ هوش مصنوعی کشفشده ارزیابی ریسک ارائه میدهد و اپها با برچسب Sanctioned یا Unsanctioned طبقهبندی میشوند.[۱]
- به تحلیل تازهٔ هاروارد بیزینس ریویو، کارکنان بهدلیل ابزارهای شرکتی دستوپاگیر یا نبود دسترسی، بیاطلاع فناوری اطلاعات از ChatGPT و Claude شخصی استفاده میکنند.[۴]
- برای دیدن دادهٔ حساس در سایتهای هوش مصنوعی مولد شخص ثالث و اعمال Endpoint DLP، دستگاهها باید به Microsoft Purview متصل باشند و افزونهٔ مرورگر Purview روی کاربران ویندوز مستقر شود.[۲]
- برای اپهای هوش مصنوعی بهجز Microsoft 365 Copilot و Microsoft Facilitator، راهاندازی صورتحساب pay-as-you-go برای سازمان لازم است.[۲]
- چارچوب AI RMF نهاد NIST در ۲۶ ژانویهٔ ۲۰۲۳ منتشر شد و استفادهٔ آن داوطلبانه است؛ پروفایل هوش مصنوعی مولد NIST-AI-600-1 در ۲۶ ژوئیهٔ ۲۰۲۴ منتشر شد.[۳]
آنچه منابع ثابت میکنند: تقاضای پنهان و کشف پیش از مسدودسازی
تحلیل تازهٔ هاروارد بیزینس ریویو پیشنهاد میکند شرکتها بهجای برخورد با استفادهٔ غیرمجاز کارکنان از ابزارهای مصرفی هوش مصنوعی بهعنوان یک مسئلهٔ انطباق، آن را نشانهٔ تقاضای استفادهنشده بدانند و همان انرژی را به مسیر دیگری هدایت کنند[۴]. همین تحلیل، علت رفتن کارکنان به مسیر شخصی را دو چیز میداند: ابزارهای شرکتی دستوپاگیر یا نبود دسترسی[۴]. یعنی موضوع پیش از آنکه دوگانهٔ امنیت در برابر بهرهوری باشد، یک شکاف کیفیت میان مسیر رسمی و مسیر شخصی است.
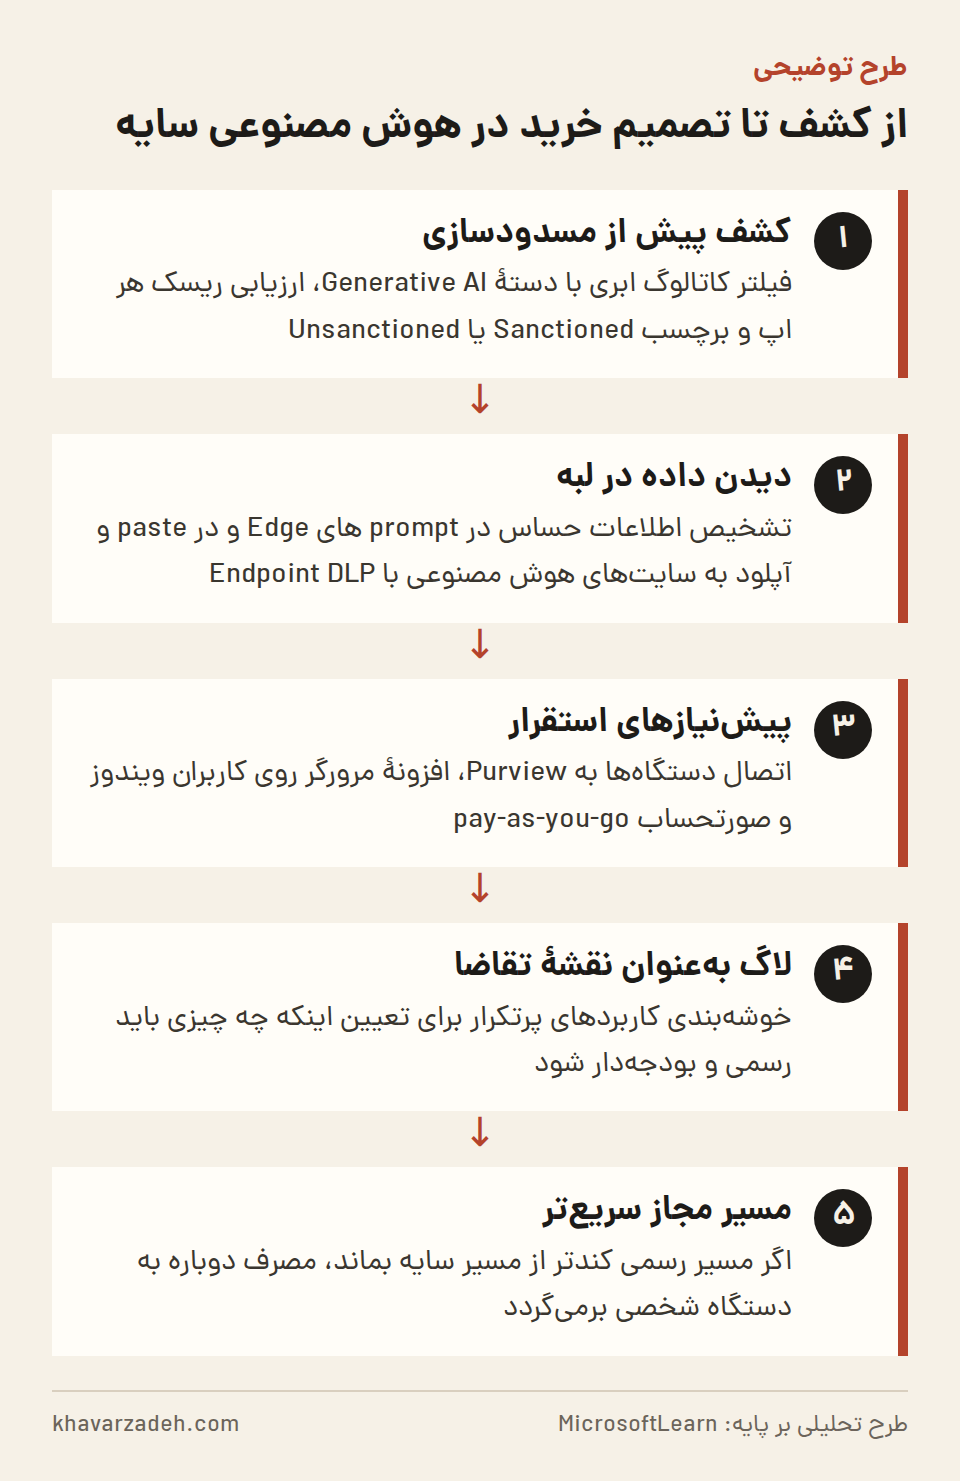
مستندات مرجع Microsoft Learn برای جلوگیری از نشت داده به هوش مصنوعی سایه چهار گام دارد و گام نخست را صریحاً به کشف و پایش اختصاص میدهد، پیش از هر اقدام مسدودکننده[۱]. در این گام، Defender for Cloud Apps کاتالوگ اپهای ابری را با دستهٔ Generative AI فیلتر میکند، برای هر اپ کشفشده ارزیابی ریسک ارائه میدهد و سازمان بر همین اساس اپ را Sanctioned یا Unsanctioned برچسب میزند[۱]. توصیه شده است پیش از تصمیم دربارهٔ تأیید یا رد، روند استفاده در داشبورد کشف ابری دیده شود[۱]. سه سیاست مکمل هم تعریف شده است: تشخیص بازدید کاربران از سایتهای هوش مصنوعی با Insider Risk Management، تشخیص اطلاعات حساس در prompt ها داخل Microsoft Edge با Purview Browser Data Security، و تشخیص اطلاعات حساسی که در سایتهای هوش مصنوعی paste یا آپلود میشود با Endpoint DLP[۱].
در لایهٔ چارچوب هم تصویر مشابهی دیده میشود. سند پایهای NIST با عنوان AI Risk Management Framework که بر پایهٔ همان سند در ۲۶ ژانویهٔ ۲۰۲۳ منتشر شده، استفادهٔ داوطلبانه دارد و هدفش وارد کردن ملاحظات اعتمادپذیری به طراحی، توسعه، استفاده و ارزیابی محصولات و سامانههای هوش مصنوعی است[۳]. پروفایل هوش مصنوعی مولد آن با شناسهٔ NIST-AI-600-1 در ۲۶ ژوئیهٔ ۲۰۲۴ منتشر شد تا سازمانها ریسکهای خاص این دسته از سامانهها را شناسایی کنند و اقدامهای متناسب با اهداف و اولویتهای خودشان را انتخاب کنند[۳].
چرا بستن دامنه نقطهٔ کنترل نیست
برداشت ما این است که مسدودکردن دامنه یک کنترل نیست، یک جابهجایی است. کاری که با بستن انجام میشود، بالا بردن اصطکاک مسیر رسمی نسبت به مسیر سایه است، و کارمندی که زیر فشار زمان کار میکند همان مسیری را انتخاب میکند که سریعتر جواب میدهد. نتیجهٔ عملی این است که داده همچنان از سازمان خارج میشود، اما دیگر اثری در لاگها نمیگذارد و تیم امنیت و حقوقی نه میتواند اندازهاش را بگوید نه محتوایش را.
به نظر میرسد نقطهٔ کنترل مؤثر ترکیبی از سه چیز است: یک مسیر مجاز که از مسیر سایه سریعتر باشد، کنترل خروج داده در لایهٔ مرورگر و شبکه بهجای لایهٔ دامنه، و تحلیل لاگها بهعنوان ورودی تصمیم خرید. این سه با هم کار میکنند؛ هرکدام بهتنهایی یا امنیت بدون کارایی میسازد یا کارایی بدون رؤیتپذیری.
اثر ثانویهٔ محتملی که آن را تفسیر خودمان میدانیم: هرچه استفادهٔ سایه از چت ساده به اجرای خودکار کار حرکت کند، هزینهٔ نادیدهگرفتن آن غیرخطی بالا میرود، چون موضوع از نشت متن به اقدام روی سامانههای واقعی تغییر میکند و آنجا هویت و دسترسی عاملها تعیینکننده میشود، نه سیاست دامنه. سازمانی که امروز فقط بلاک میکند، فردا هیچ پایهای برای طراحی این لایه ندارد.
هزینه و پیشنیازهایی که پروژهٔ حکمرانی را زمین میزند
رؤیتپذیری در لایهٔ مرورگر و endpoint رایگان و بیزحمت نیست و همین جا بیشتر برنامهها متوقف میشوند. برای دیدن اطلاعات حساسی که با سایتهای هوش مصنوعی مولد شخص ثالث به اشتراک گذاشته میشود و برای اعمال سیاستهای Endpoint DLP، دستگاهها باید به Microsoft Purview متصل شده باشند[۲]. افزونهٔ مرورگر Purview باید روی کاربران ویندوز مستقر شود؛ این افزونه برای کشف بازدید از سایتهای هوش مصنوعی مولد شخص ثالث با سیاست Insider Risk Management لازم است و در ویندوز، هنگام استفاده از Chrome، برای سیاستهای Endpoint DLP هم ضروری است[۲].
نمونهای که خود مستندات میآورد گویاست: کاربری که در Adaptive Protection پرریسک شناخته شده، هنگام paste کردن شمارههای کارت اعتباری در ChatGPT مسدود میشود، با امکان override[۲]. نکتهٔ بودجهای هم صریح است: برای اپهای هوش مصنوعی بهجز Microsoft 365 Copilot و Microsoft Facilitator، سازمان باید صورتحساب pay-as-you-go را راهاندازی کرده باشد[۲]. محدودیت سازمانی هم وجود دارد؛ مدیران محدودشده نمیتوانند سیاستهای یککلیکی را که برای همهٔ کاربران اعمال میشود بسازند و فقط نتایج واحد اداری خودشان را میبینند[۲].
و یک هشدار دربارهٔ پایداری ابزار: همان مستندات تصریح میکند نسخهٔ کلاسیک DSPM for AI با نسخهٔ جدیدی جایگزین شده که پشتیبانی از اپها و عاملهای هوش مصنوعی، قابلیتهای تازه و مدیریت سادهتر را اضافه میکند و بهبودها به نسخهٔ کلاسیک افزوده نمیشود[۲]. هر طرح حکمرانی که روی یک نسخهٔ مشخص از یک محصول قفل شود، سربار مهاجرت را هم باید در برآورد بیاورد.
لاگ بهعنوان نقشهٔ تقاضا
ارزش اصلی دادهای که از گام کشف به دست میآید امنیتی نیست؛ محصولی است. فهرست اپهای پرکاربرد، واحدهایی که بیشترین ترافیک را دارند و نوع کاری که در prompt ها تکرار میشود، دقیقترین نقشهٔ تقاضای موجود برای هوش مصنوعی در سازمان است، و برخلاف نظرسنجی داخلی، رفتار واقعی را نشان میدهد نه ترجیح اعلامشده را. برداشت ما این است که تیم محصول و داده باید همانطور با این لاگها برخورد کند که با دادههای رفتاری کاربر بیرونی برخورد میکند: خوشهبندی کاربردها، تشخیص وظایف پرتکرار و انتخاب دو یا سه مورد برای رسمیسازی و بودجهگرفتن.
از اینجا به بعد تصمیم ساده میشود. کاربردهایی که پرتکرارند و دادهٔ حساس ندارند باید مسیر مجاز و سریع بگیرند؛ کاربردهایی که پرتکرارند و دادهٔ حساس دارند باید داخلی یا قراردادی شوند؛ و مسدودسازی فقط برای بخش کوچکی میماند که نه ارزش کاری روشنی دارد نه ریسکش قابل مهار است. این همان جایی است که مدل عملیاتی هوش مصنوعی و سنجش استفادهٔ واقعی به هم وصل میشوند، چون بدون معیار استفاده، رسمیسازی به خرید لایسنس بلااستفاده ختم میشود.
آیا تیتر رایج دربارهٔ هوش مصنوعی سایه اغراقآمیز است؟ تا حدی بله: منابع در دسترس یک الگوی رفتاری و یک توالی کنترلی را نشان میدهند، اما عددی دربارهٔ اندازهٔ نشت یا خسارت ارائه نمیکنند. آنچه میتوان به آن تکیه کرد این است که تقاضا وجود دارد، ابزار کنترل و پیشنیازهایش مستند شدهاند و ترتیب توصیهشده کشف پیش از مسدودسازی است؛ ادعای بیش از این باید با دادهٔ خود سازمان پشتیبانی شود، نه با روایت عمومی بازار.
| لایه | کاری که انجام میدهد | پیشنیاز یا نکتهٔ عملیاتی |
|---|---|---|
| کشف اپ | فیلتر کاتالوگ ابری با دستهٔ Generative AI و ارزیابی ریسک هر اپ [S1] | برچسبگذاری Sanctioned یا Unsanctioned بر اساس سیاست سازمان [S1] |
| کشف تعامل | گزارشهای DSPM for AI و activity explorer برای دیدن تعامل کاربران [S1] | اتصال دستگاهها به Microsoft Purview [S2] |
| مرورگر | تشخیص اطلاعات حساس در prompt ها داخل Microsoft Edge [S1] | استقرار افزونهٔ مرورگر Purview روی کاربران ویندوز [S2] |
| Endpoint | تشخیص یا مسدودسازی paste و آپلود اطلاعات حساس در سایتهای هوش مصنوعی [S1] | در ویندوز با Chrome، افزونهٔ مرورگر Purview لازم است [S2] |
| ریسک داخلی | دیدن بازدید از سایتهای هوش مصنوعی و تعاملهای پرریسک در مرورگر و شبکه [S1] | پیکربندی سیاست Insider Risk Management [S1] |
| صورتحساب | پوشش اپهای هوش مصنوعی غیر از Microsoft 365 Copilot و Microsoft Facilitator [S2] | راهاندازی pay-as-you-go برای سازمان [S2] |
خط زمانی
- 2023-01-26: انتشار AI Risk Management Framework نسخهٔ ۱٫۰ توسط NIST با کاربرد داوطلبانه[۳]
- 2023-03-30: راهاندازی مرکز منابع هوش مصنوعی قابلاعتماد و مسئولانه توسط NIST برای تسهیل پیادهسازی چارچوب[۳]
- 2024-07-26: انتشار NIST-AI-600-1، پروفایل هوش مصنوعی مولد برای شناسایی ریسکهای خاص این دسته[۳]
- 2026-04-07: انتشار یادداشت مفهومی NIST برای پروفایل هوش مصنوعی قابلاعتماد در زیرساخت حیاتی[۳]
- 2026-04-14: تحلیل هاروارد بیزینس ریویو: استفادهٔ غیرمجاز کارکنان را نشانهٔ تقاضای استفادهنشده بدانید[۴]
برای کسبوکارهای ایرانی
برای سازمانهای ایرانی بخشی از این الگو شدیدتر عمل میکند: وقتی دسترسی به سرویسهای ابری ناپایدار یا محدود است، مسیر سایه با حساب شخصی و دستگاه شخصی عملاً به پیشفرض تبدیل میشود و لاگی هم باقی نمیماند. مجموعه ابزارهایی که در مستندات آمده به اتصال دستگاهها، استقرار افزونهٔ مرورگر و راهاندازی صورتحساب pay-as-you-go وابسته است[۲]. برداشت ما این است که تأمین این پیشنیازها برای بسیاری از تیمهای داخلی عملی نیست و معادل کاربردی آن، کنترل خروج داده در لایهٔ پروکسی و شبکه، ثبت لاگ مسیر مجاز، و استقرار داخلی مدلهای open-weight برای کاربردهای پرتکرار و حساس است تا مسیر رسمی از مسیر سایه سریعتر شود. این یک ملاحظهٔ فنی است، نه توصیهٔ خرید یا سرمایهگذاری.
چه چیزی را باید دنبال کرد
- نسبت کاربردهای پرتکرار کشفشده در لاگها به کاربردهایی که رسمی و بودجهدار شدهاند؛ اگر این نسبت پایین بماند، مسیر سایه دوباره پهن میشود.
- سربار مهاجرت از نسخهٔ کلاسیک DSPM for AI به نسخهٔ جدید و اینکه پوشش اپها و عاملها چقدر تغییر میکند[۲]
- نرخ override در سیاستهای مسدودسازی endpoint بهعنوان معیار اینکه سیاست با کار واقعی جور است یا فقط اصطکاک میسازد[۲]
- تکامل پروفایلهای NIST برای هوش مصنوعی مولد و زیرساخت حیاتی و اینکه چه الزامات مستندسازی به تیمهای داخلی منتقل میکند[۳]
دادههای مرتبط در همین سایت: دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- Step 1: Discover AI apps - Prevent data leak to shadow AI — MicrosoftLearn، منبع مرجع، دسترسی: 2026-09-29
- Considerations for deploying Microsoft Purview Data Security Posture Management (DSPM) for AI — MicrosoftLearn، منبع مرجع، دسترسی: 2026-09-29
- AI Risk Management Framework — NIST، منبع مرجع، دسترسی: 2026-09-29
- The Hidden Demand for AI Inside Your Company — Harvard Business Review، انتشار: 2026-04-14، شواهد تازه، دسترسی: 2026-09-29
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-29.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر