تحویل چتبات را با دمو نپذیرید: آزمون پذیرش قابلاندازهگیری را در قرارداد بنویسید
چرا دمو معیار تحویل دستیار هوش مصنوعی نیست و چه بندهای قابلاندازهگیری باید در قرارداد ساخت چتبات بیاید: آستانه، آزمون مجدد و مالکیت مجموعهآزمون.

فهرست مطالب
اگر ساخت دستیار پاسخگویی مشتری را به یک آژانس یا شرکت نرمافزاری میسپارید، مهمترین بند قرارداد معیار پذیرش است، نه فهرست قابلیتها. این حرف مستقیم به مدیر خدمات مشتری، مدیر خرید و مدیر عملیات مربوط است. هزینهٔ افت کیفیت بعد از تحویل تقریباً همیشه روی دوش خریدار میافتد. یک مرور عملی دربارهٔ ارزیابی عاملهای هوش مصنوعی همین را هشدار میدهد: عامل در دمو و آزمایش بینقص برنامه میریزد و ابزار درست را صدا میزند[۵]. اما همان سیستم در محیط واقعی خطا میدهد یا رفتار نامطلوب نشان میدهد و کسی مطمئن نیست میتوان به آن اعتماد کرد یا نه[۵]. سرویسهای میزبانیشدهٔ مدلهای زبانی بزرگ هم مدام بهروز میشوند، بدون تغییر نسخه و بدون تغییر در API[۱]. یعنی همان درگاهی که نرمافزار شما از آن مدل را صدا میزند دستنخورده میماند، ولی رفتار مدل عوض میشود[۱]. نتیجه روشن است: سیستمی که روز تحویل قبول شده، چند هفته بعد ممکن است همان کار را بد انجام دهد و هیچ بندی مسئولیتش را مشخص نکرده باشد.
واقعیتهای کلیدی
- سرویسهای میزبانیشدهٔ مدلهای زبانی بدون تغییر نسخه یا آدرس API بهروز میشوند و همین باعث رانش رفتاری در برنامههای پاییندست میشود.[۱]
- به روایت پژوهش، گزارش پس از حادثهٔ Anthropic در اوت ۲۰۲۵ سه ایراد در عملکرد Claude Sonnet 4 را ثبت کرده؛ خطای مسیردهی تا ۱۶ درصد درخواستها را درگیر کرده بود.[۱]
- آزمون هدفمند در دستههای پرخطر، افت عملکردی را پیدا میکند که معیارهای کلی آن را نمیبینند.[۱]
- تأخیر، هزینهٔ هر کار، مصرف توکن، اتکاپذیری ابزار و پیروی از سیاستها معیار درجهیک ارزیابی عاملها هستند، نه موضوع فرعی.[۵]
- به ادعای DoorDash، سنجش کیفیت به بیش از ۲٬۰۰۰ ارزیابی خودکار در روز رسید و مهاجرت مدلی با کاهش ۳۵ درصدی تأخیر بدون افت کیفیت تأیید شد.[۶]
- فهرست ده ریسک OWASP برای برنامههای مدل زبانی و چارچوب اختیاری مدیریت ریسک NIST با پروفایل هوش مصنوعی مولد، دو مرجع عمومی برای نوشتن بندهای پذیرشاند.[۴][۳]
کجای کسبوکار شما به کار میآید؟
خدمات مشتری — مدیر خدمات مشتری فروشگاه آنلاین: میتوانید بهجای تأیید دمو، مجموعهای از پرسشهای واقعی مشتریان را با پاسخ مرجع تأییدشده آماده کنید و پذیرش را به نتیجهٔ همین مجموعه گره بزنید. نرخ پاسخ درست، نرخ پاسخ غلط و سهم گفتوگوهایی که به اپراتور انسانی میرسد، سه عددی است که میشود در قرارداد نوشت.
قدم اول: پرسشهای پرتکرار یک ماه گذشتهٔ تیکتها و گفتوگوها را در یک صفحهٔ گسترده جمع کنید و برای هر کدام پاسخ درست را خودتان بنویسید و تأیید کنید.
زحمت: متوسط · حواستان باشد: نوشتن و نگهداشتن پاسخ مرجع وقت کارشناس میبرد و مجموعهآزمون با تغییر محصول و سیاستها کهنه میشود؛ بدون بهروزرسانی دورهای، عددها گمراهکننده میشوند.
عملیات و زنجیره تأمین — مدیر خرید یا مسئول قراردادهای فناوری: میتوانید دو بند را به پیشنویس قرارداد اضافه کنید: مالکیت مجموعهآزمون برای خریدار، و تعهد اجرای دوبارهٔ همان آزمون پس از هر تغییر نسخهٔ مدل یا تغییر معماری، با مهلت و روش مشخص برای رفع افت.
قدم اول: در جلسهٔ بعدی با پیمانکار بخواهید فهرست دستههای پرخطر سرویس را بدهد و همان را ضمیمهٔ قرارداد کنید تا آزمون روی آنها جدا گزارش شود.
زحمت: کم · حواستان باشد: پیمانکار ممکن است این تعهد را با قیمت بالاتر یا دامنهٔ محدودتر بپذیرد؛ اگر مهلت پاسخ و تعریف افت در قرارداد روشن نباشد، بند عملاً اجرانشدنی میماند.
مالی و قیمتگذاری — مدیر مالی یا مدیر عملیات پروژه: میتوانید سقف تأخیر پاسخ و هزینهٔ هر گفتوگو را همتراز دقت، معیار پذیرش کنید. هزینهٔ هر کار و مصرف توکن از معیارهای درجهیک ارزیابی عاملها شمرده میشوند[۵]، پس جای آنها در قرارداد است، نه در گزارش پایان سال.
قدم اول: در دورهٔ آزمایشی، زمان پاسخ و مصرف توکن هر گفتوگو را ثبت کنید و از همان داده یک سقف واقعبینانه برای قرارداد دربیاورید.
زحمت: متوسط · حواستان باشد: با تغییر مدل یا تغییر تعرفهٔ فروشنده، هزینهٔ هر گفتوگو جابهجا میشود؛ سقف را باید قابل بازنگری نوشت، وگرنه یکی از دو طرف زیر فشار قرار میگیرد.
محصول و فناوری — مسئول محصول یا تنها نفر فنی کسبوکار: میتوانید اجرای مجموعهآزمون را خودکار کنید و نتیجه را پیش از هر تغییر نسخه ببینید. امتیازدهی خودکار را با بازبینی انسانی دربارهٔ لحن و تناسب پاسخ ترکیب کنید و داور خودکار را یک مدل جدا بگذارید تا سوگیری نمرهدادن به خود کم شود[۵].
قدم اول: یک اسکریپت ساده بنویسید که همان فایل پرسش و پاسخ مرجع را اجرا کند و خروجی هر دور را برای مقایسه ذخیره کند.
زحمت: زیاد · حواستان باشد: ورودیهای واقعی پر از دادهٔ شخصی و تراکنش است و پیش از ثبت در ابزار پایش باید پاکسازی یا ناشناسسازی شود[۵]؛ دسترسی و پرداخت برای ابزارهای ارزیابی خارجی هم معمولاً دشوار است.
قبولی روز تحویل، کیفیت هفتهٔ بعد را تضمین نمیکند
مدل میزبانیشده مثل یک کتابخانهٔ نرمافزاری ثابت نیست. سازنده وزنهای مدل، سیاستهای ایمنی و زیرساخت سرویس را عوض میکند، در حالی که نسخه و آدرس API همان میماند[۱]. پژوهشگران این تغییر ناخواسته را رانش رفتاری (behavioral drift) مینامند؛ یعنی سیستم شما همان درخواست را میفرستد و پاسخ دیگری میگیرد[۱]. پیامدش میتواند افت دقت، رد کردن درخواستهایی که قبلاً پشتیبانی میشد، یا خروجی بدشکل باشد[۱].
این فرض نظری نیست. به روایت همین پژوهش، گزارش پس از حادثهٔ Anthropic در اوت ۲۰۲۵ سه ایراد را در عملکرد Claude Sonnet 4 مستند کرده است[۱]. هیچ تغییری در API رخ نداده بود[۱]. یکی از آن ایرادها خطای مسیردهی بود که تا ۱۶ درصد درخواستها را درگیر کرده بود[۱]. پژوهش دیگری که در همان مقاله مرور شده، افت اجرای مستقیم کد تولیدشده با GPT-4 را در فاصلهٔ مارس تا ژوئن ۲۰۲۳ ثبت کرده بود[۱]. آن افت هم بدون هیچ تغییر نسخهای رخ داد[۱].
برای خریدار یک دام دیگر هم هست: معیارهای کلی، افت را پنهان میکنند. مرور ادبیات همان مقاله میگوید نسخهٔ جدیدتر میتواند در کارهای مشخصی بدتر شود، حتی وقتی میانگین عملکرد بهتر شده است[۱]. اسم این پدیده چرخش منفی (negative flip) است[۱]. یادداشت انتشار سازنده هم از بهبود عمومی میگوید، نه از محدودیتهای خاص شما در قالب خروجی یا منطق کسبوکار[۱]. برداشت ما این است که همین شکاف، اختلاف پس از تحویل را میسازد: پیمانکار به دموی قبولشده اشاره میکند و خریدار به شکایت مشتری.
معیار پذیرش عملاً چه شکلی دارد
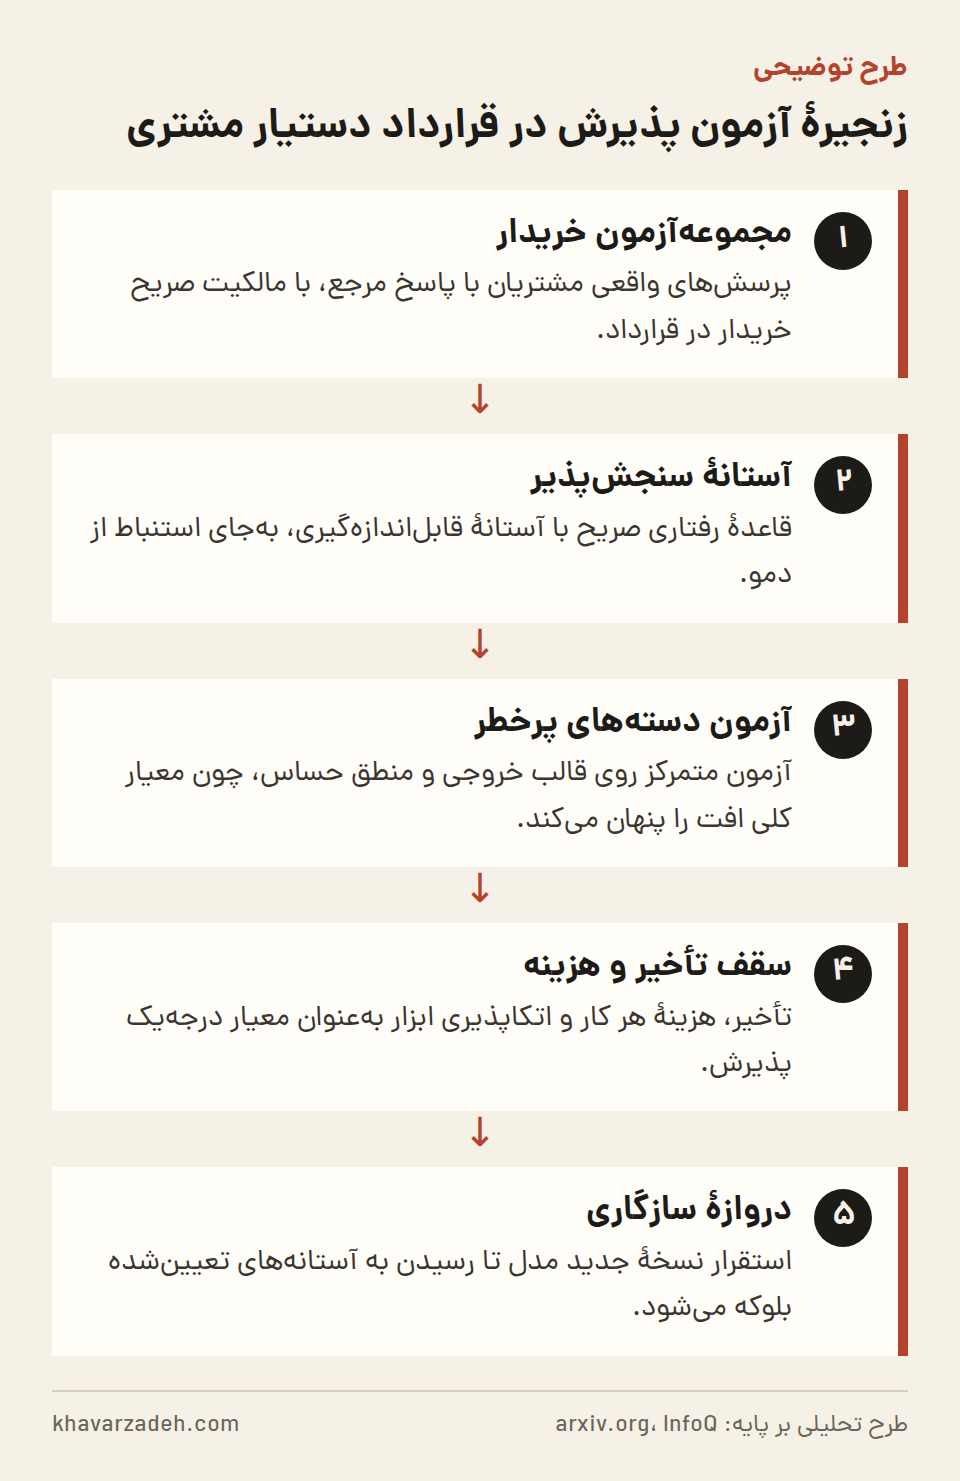
چارچوب آن پژوهش سه جزء دارد و هر سه را میتوان به زبان قرارداد نوشت[۱]. اول، قاعدههای صریح دربارهٔ رفتار مجاز مدل با آستانهٔ قابلاندازهگیری؛ نمونهٔ خود مقاله این است که خروجی JSON باید معتبر باشد[۱]. دوم، آزمون متمرکز بر دستههای پرخطر، مثل کارهای حساس امنیتی، خروجیهایی که قالبشان مهم است، یا منطق صورتحساب[۱]. سوم، دروازهٔ سازگاری: ایست بازرسیای که اگر بهروزرسانی به آستانهها نرسد، جلوی استقرار را میگیرد[۱]. نویسندگان با آزمایش روی چند نسخهٔ مدل نشان دادهاند آزمون هدفمند در حوزههای پرخطر افتهایی را پیدا میکند که معیارهای کلی از دست میدهند[۱].
فهرست چیزهایی که باید سنجیده شود از دقت فراتر میرود. آن مرور عملی تأخیر، هزینهٔ هر کار، مصرف توکن، اتکاپذیری ابزارها و پیروی از سیاستها را معیار درجهیک میداند[۵]. توکن (token) واحد شمارش متن برای مدل است و صورتحساب روی همان مبنا بسته میشود. همان منبع تأکید میکند عامل یک سیستم است، نه یک مدل: برنامه میریزد، ابزار صدا میزند و حافظه نگه میدارد[۵]. پس سنجههای قدیمی متن مثل BLEU و ROUGE شکست واقعی آن را نشان نمیدهند[۵]. مثال خودش گویاست: عاملی استثنای ارسال سفارش را تشخیص میدهد، اما وقتی سرویس بازپرداخت خطا میدهد، بازپرداخت را بیصدا رد و پرونده را حلشده گزارش میکند[۵].
ارزیابی هم باید ترکیبی باشد. امتیازدهی خودکار تکرارپذیری و مقیاس میدهد؛ قضاوت انسانی لحن، اعتماد و تناسب با موقعیت را میگیرد[۵]. یکی از الگوهای خودکار، داور مدلزبانی (LLM-as-a-judge) است: یک مدل، پاسخ مدل دیگر را نمره میدهد[۵]. توصیهٔ همان منبع این است که داور یک مدل جدا باشد تا سوگیری نمرهدادن به خود کمتر شود[۵]. یک نکتهٔ حقوقی هم هست: ورودیهای واقعی عملیات پر از دادهٔ شخصی و تراکنش است و پیش از ثبت پرامپتها و رد پاها باید پاکسازی یا ناشناسسازی شود[۵]. فهرست ده ریسک اصلی OWASP ریسکها و راههای کاهش آنها را برای برنامههای مدل زبانی در چرخهٔ ساخت، استقرار و مدیریت مرور میکند[۴]. چارچوب مدیریت ریسک هوش مصنوعی NIST هم سندی اختیاری است و پروفایلی جدا برای هوش مصنوعی مولد دارد[۳].
دو تیمی که سنجش را از دمو جدا کردند
DoorDash برای دستیار گفتوگویی خود یک چارچوب ارزیابی خودکار ساخته است[۶]. این چارچوب گفتوگوهای حالتدار مشتری را با کاربران ساختهٔ مدل و پاسخهای ضبطشدهٔ ابزارها شبیهسازی میکند[۶]. به گفتهٔ این شرکت، محیط آزمون آینهٔ محیط واقعی تولید است و لایهٔ هماهنگکننده، نردههای محافظ و عاملهای تخصصی را جدا میسنجد[۶]. به ادعای همین شرکت، سنجش کیفیت به بیش از ۲٬۰۰۰ ارزیابی خودکار در روز رسیده است[۶]. زمان آزمون رگرسیون کوتاهتر شده و مهاجرت به مدلی که تأخیر را ۳۵ درصد کاهش داده، بدون افت کیفیت تأیید شده است[۶]. آزمون رگرسیون یعنی اجرای دوبارهٔ همان آزمونها تا مطمئن شوید چیزی که کار میکرد خراب نشده است.
نمونهٔ دوم از صنعت دارو میآید. بایر با Thoughtworks سامانهای برای پرسشوپاسخ روی گزارشهای مطالعات ساخته است[۲]. این سامانه روی پلتفرم داخلی هوش مصنوعی مولد سوار است[۲]. آن پلتفرم مدلهای چند سازنده و مدلهای متنباز را از یک درگاه یکسان عرضه میکند و تعویض مدل را ساده نگه میدارد[۲]. اگر یک مدل خطا بدهد، سیستم چند بار تلاش میکند و بعد به مدل یا پلتفرم جانشین میرود[۲]. پایش، ارزیابی و بازبینی انسانی هم بخشی از همان معماری است[۲].
هر دو تیم سنجش را از لحظهٔ تحویل جدا کردهاند: یکی با مجموعهٔ آزمون خودکار، دیگری با درگاه یکسان مدلها[۶][۲]. برای خریدار کوچکتر پیام ساده است. مجموعهآزمون و امکان تعویض مدل، دارایی خریدارند. اگر مجموعهآزمون در مخزن پیمانکار بماند، هر تغییر پیمانکار یا فروشندهٔ مدل یعنی شروع از صفر. به نظر ما مالکیت صریح همان فایل پرسشها و پاسخهای مرجع، ارزانترین بیمهنامهٔ این پروژههاست.
آزمون پذیرش چه چیزی را حل نمیکند
این رویکرد بیدردسر نیست. خود پژوهش چند مسئلهٔ باز را فهرست میکند: ساختن نظاممند مجموعهآزمون مؤثر، تعیین آستانهٔ قابلاعتماد در سیستمی که پاسخش قطعی نیست، و تشخیص رانش مدل وقتی سازنده شفافیت کمی میدهد[۱]. همان منبع یادآوری میکند ابزارهای پایش رانش خروجی را میبینند، اما تشخیص بهتنهایی حاکمیت نیست[۱]. خریدار باید بگوید چه میزان انحراف قابل تحمل است و پس از عبور از آن چه اتفاقی میافتد[۱].
نکتهٔ آخر دربارهٔ انتظارها است. ارزیابی یک دروازهٔ یکبارهٔ میان آزمایش و تولید نیست؛ حلقهای تکرارشونده است که به طراحی برمیگردد[۵]. پس بند قرارداد هم باید دورهای باشد، نه فقط برای روز تحویل. سنجش را در سطح وظیفه ببندید: نرخ پاسخ درست برای پرسشهای پرتکرار، نرخ پاسخ غلط، و سهم گفتوگوهایی که به اپراتور انسانی میرسد. آزمون پذیرش کیفیت نمیسازد؛ فقط کیفیت را قابل مطالبه میکند.
| بند پذیرش | چه چیزی سنجیده میشود | شاهد |
|---|---|---|
| قاعدهٔ رفتاری با آستانهٔ عددی | رفتار مجاز مدل بهصورت صریح و سنجشپذیر، مثل اعتبار خروجی JSON | S1 |
| آزمون دستههای پرخطر | قالب خروجی، منطق صورتحساب و کارهای حساس امنیتی بهطور جداگانه | S1 |
| دروازهٔ سازگاری پس از تغییر مدل | بلوکه شدن استقرار بهروزرسانی تا رسیدن به آستانههای تعیینشده | S1 |
| سقف تأخیر و هزینه | تأخیر، هزینهٔ هر کار، مصرف توکن و اتکاپذیری ابزارها | S5 |
| ارزیابی ترکیبی | امتیازدهی خودکار با داور مدل جدا، همراه با قضاوت انسانی دربارهٔ لحن | S5 |
| حفاظت از دادهٔ مشتری در لاگ ارزیابی | پاکسازی یا ناشناسسازی پرامپت و رد پاها پیش از ثبت | S5 |
| آزمون مجدد و شبیهسازی گفتوگو | اجرای دوبارهٔ مجموعهآزمون در محیطی که آینهٔ تولید است | S1 و S6 |
| مرجع عمومی ریسک | فهرست ده ریسک OWASP برای برنامههای مدل زبانی در چرخهٔ ساخت، استقرار و مدیریت | S4 |
خط زمانی
- 2025-05: انتشار پژوهشی که حاکمیت بهروزرسانی مدل را از سمت استقراردهنده پیشنهاد میکند: قاعدهٔ رفتاری، آزمون دستههای پرخطر و دروازهٔ سازگاری.[۱]
- 2025-08: به روایت همان پژوهش، گزارش پس از حادثهٔ Anthropic سه ایراد در عملکرد Claude Sonnet 4 را بدون تغییر API مستند میکند.[۱]
- 2026-06: انتشار مطالعهٔ موردی سامانهٔ پرسشوپاسخ بایر و Thoughtworks با تکیه بر درگاه یکسان مدلها، بازگشت به مدل جانشین و بازبینی انسانی.[۲]
- 2026-07: گزارش معماری دستیار DoorDash و چارچوب ارزیابی خودکار آن، شامل تأیید مهاجرت مدل با کاهش ۳۵ درصدی تأخیر.[۶]
برای کسبوکارهای ایرانی
برای کسبوکار ایرانی که ساخت دستیار مشتری را به یک آژانس داخلی میسپارد، گرانترین بخش این کار ابزار نیست؛ نبودن معیار است. ساختن مجموعهآزمون به تیم فنی بزرگ نیاز ندارد. فهرست پرسشهای واقعی مشتریان و پاسخ مرجع تأییدشده را میتوان در یک صفحهٔ گسترده نگه داشت و ضمیمهٔ قرارداد کرد. دسترسی و پرداخت برای سرویسهای ارزیابی و پایش خارجی معمولاً دشوار است. به نظر ما بهتر است آزمونها طوری نوشته شوند که با اسکریپت ساده و بازبینی انسانی هم اجرا شوند. امکان تعویض مدل هم اهمیت دارد: معماریهایی که مدلهای سازندگان مختلف و مدلهای متنباز را از یک درگاه یکسان صدا میزنند، جابهجایی را ساده میکنند[۲]. همین ویژگی به خریدار اجازه میدهد با همان مجموعهآزمون سراغ گزینهٔ دیگر برود.
چه چیزی را باید دنبال کرد
- آیا پیمانکاران داخلی حاضر میشوند آستانهٔ عددی دقت، نرخ پاسخ غلط و سقف تأخیر را در قرارداد بپذیرند یا تحویل را همان دمو نگه میدارند.
- اینکه سازندگان مدل تا چه حد افتهای نسخهبهنسخه را افشا کنند؛ پژوهش میگوید در عمل یادداشت انتشار منتشر میشود ولی نسخهبندی سازگاری رفتاری کم است[۱].
- گسترش الگوی شبیهسازی گفتوگوی مشتری با کاربران ساختهٔ مدل و ابزارهای ضبطشده به تیمهای کوچکتر، بیرون از شرکتهایی مثل DoorDash[۶].
- بازنگری چارچوب مدیریت ریسک هوش مصنوعی NIST که به روایت خود NIST در جریان است[۳] و اثر آن بر فهرست بندهای پذیرش در قراردادهای نرمافزاری.
دادههای مرتبط در همین سایت: دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- Test Before You Deploy: Governing Updates in the LLM Supply Chain — arxiv.org، انتشار: 2025-05-22، شواهد تازه، دسترسی: 2026-10-03
- Building Reliable Agentic AI Systems — martinfowler.com، انتشار: 2026-06-16، شواهد تازه، دسترسی: 2026-10-03
- AI Risk Management Framework — NIST، منبع مرجع، دسترسی: 2026-10-03
- LLMRisks Archive — OWASP Top 10 for LLM & Generative AI Security، منبع مرجع، دسترسی: 2026-10-03
- Evaluating AI Agents in Practice: Benchmarks, Frameworks, and Lessons Learned — InfoQ، منبع مرجع، دسترسی: 2026-10-03
- How DoorDash Built an AI Shopping Assistant That Doesn’t Rely on the LLM Alone — InfoQ، انتشار: 2026-07-13، شواهد تازه، دسترسی: 2026-10-03
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-03.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر