عامل نباید روی اسکیمای خام SQL بزند: لایهٔ معنایی را به درگاه داده سازمان تبدیل کنید
چرا دسترسی مستقیم عامل هوش مصنوعی به اسکیمای خام ریسک است و چگونه ابزارهای محدود، مجوز سطح ردیف و لاگ، پاسخها را قابل حسابرسی میکند.
فهرست مطالب
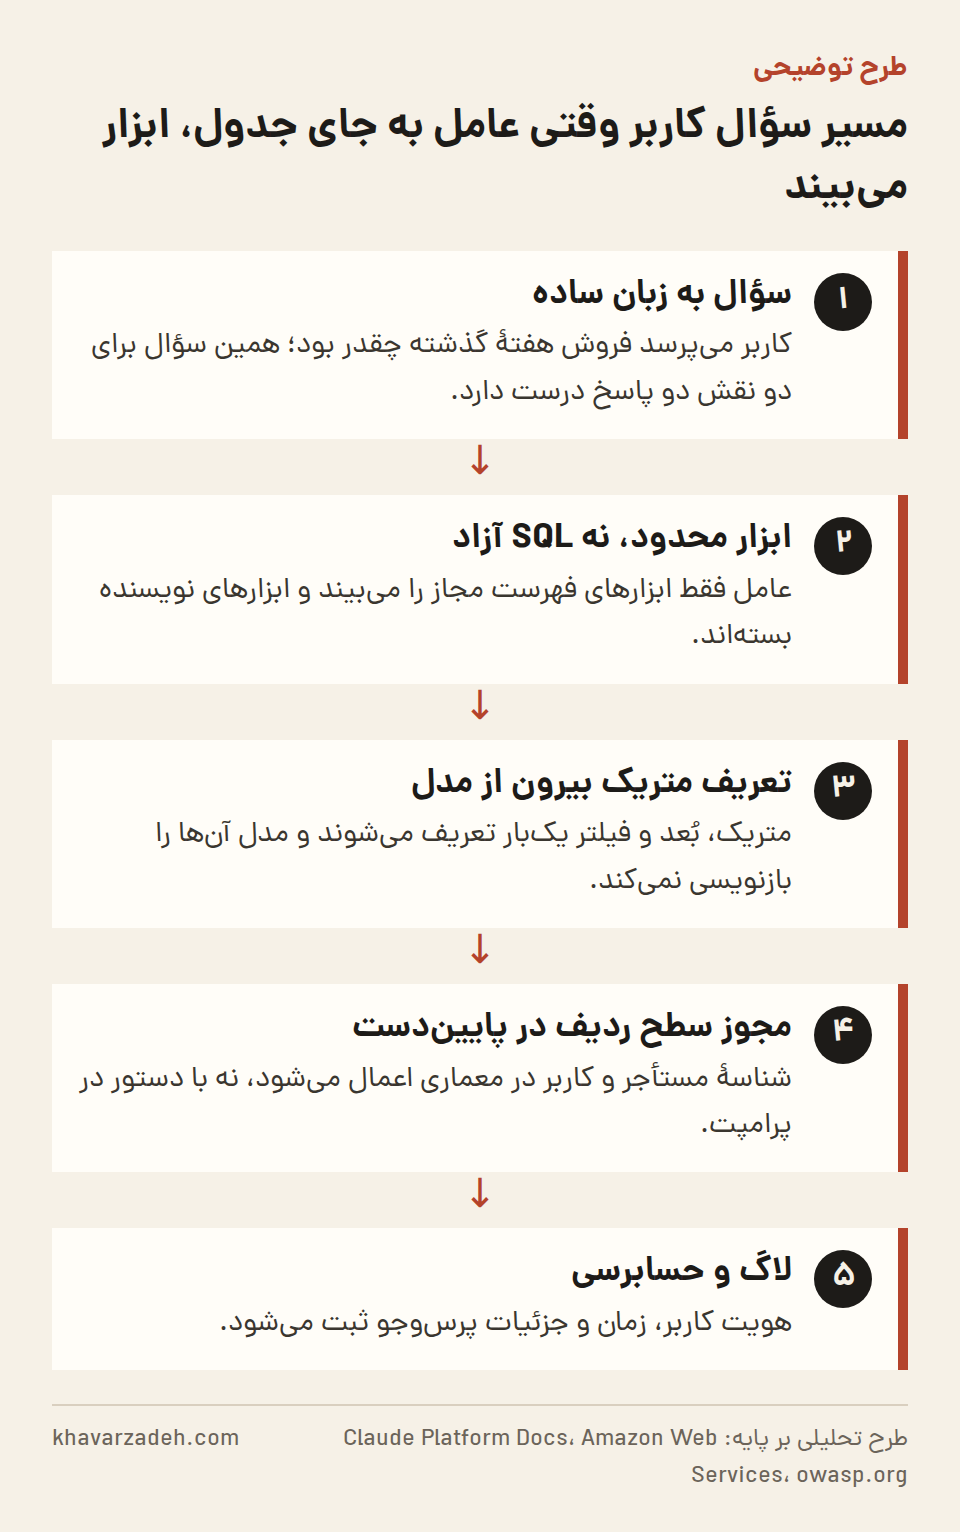
مرز دسترسی عامل هوش مصنوعی به دادهٔ سازمان یک تصمیم معماری است، نه نتیجهٔ هوش مدل. فرض کنید عاملی ساختهاید که جای تحلیلگر، پرسوجو مینویسد. اگر این عامل فهرست خام جدولها و ستونها (اسکیما) را ببیند و خودش SQL بنویسد، تعریف متریک و مرز مجوز را به مدل سپردهاید. SQL همان زبانی است که با آن از پایگاه داده سؤال میپرسند. شرح معماری شرکت PAR Technology در وبلاگ AWS نشان میدهد این سپردن در عمل چه هزینهای دارد[۳]. مسیر پایدارتر، باریک کردن سطح تماس است. عامل فقط چند ابزار محدود میبیند، تعریف متریک بیرون از مدل مینشیند و مجوز در پاییندست اعمال میشود. راهنمای OWASP دربارهٔ اختیار بیش از حد عاملها همین قاعده را توصیه میکند[۴]. حرف این مقاله ساده است: لایهٔ معنایی را به درگاه رسمی دادهٔ سازمان تبدیل کنید. درگاه یا API همان نقطهٔ مشخصی است که برنامهها از آن داده میگیرند.
واقعیتهای کلیدی
- در مثال PAR Technology، پاسخ درست به یک سؤال یکسان برای صاحب امتیاز دو شعبه فروش همان دو شعبه است و برای مدیر برندی که کل زنجیره را زیر نظر دارد ۹٫۲ میلیون دلار.[۳]
- به گفتهٔ تیم PAR، مدلهای زبانی مولدهای احتمالیاند و برای نقش مرز امنیتی قطعی کافی نیستند؛ ممکن است فیلتر مجوز را جا بیندازند یا مقدار آن را بسازند.[۳]
- این شرکت به گفتهٔ خودش به بیش از ۳۰۰ کسبوکار رستورانی سرویس میدهد و هر درخواست سه شناسهٔ مستأجر، کسبوکار و کاربر را حمل میکند.[۳]
- OWASP در مدخل اختیار بیش از حد توصیه میکند مجوزدهی در سیستمهای پاییندست پیاده شود و ابزارها و مجوزهای عامل به کمینهٔ لازم محدود بمانند.[۴]
- مستندات پلتفرم Claude (آوریل ۲۰۲۵) امکان فهرست مجاز و فهرست ممنوع ابزار را توصیف میکند و برای دستیار فقطخواندنی، بستن ابزارهای نویسنده را توصیه میکند.[۲]
- MCP استانداردی باز برای وصل کردن دستیارهای هوش مصنوعی به منابع داده است و جای یکپارچهسازی سفارشی برای هر منبع را میگیرد.[۱]
یک سؤال، دو عدد که هر دو درستاند
شرکت PAR Technology، که به گفتهٔ خودش به بیش از ۳۰۰ کسبوکار رستورانی سرویس میدهد، مثال سادهای میآورد[۳]. دو کاربر صبح یک روز وارد همان ابزار تحلیلی میشوند و عین هم میپرسند فروش کل هفتهٔ گذشته چقدر بود[۳]. کاربر اول صاحب امتیازی است که دو شعبه در شیکاگو دارد؛ پاسخ درست برای او فروش همان دو شعبه است[۳]. کاربر دوم مدیر برندی است که کل زنجیره را در سراسر کشور زیر نظر دارد؛ پاسخ درست برای او ۹٫۲ میلیون دلار است[۳]. یک سؤال، یک پایگاه داده، دو عدد درست[۳]. به گفتهٔ PAR، نشان دادن عدد ملی به صاحب امتیاز هم نقض حاکمیت داده است و هم میتواند اطلاعات تجاری بهرهبردارهای دیگر را لو بدهد[۳].
نسخهٔ اول سامانهٔ آنها همان الگوی آشنا بود: سؤال کاربر به مدل زبانی میرفت، مدل پرسوجو را میساخت و نتیجه به زبان ساده برمیگشت[۳]. برای نمونهٔ آزمایشی خوب کار کرد و مدل بیشتر سؤالها را درست میفهمید[۳]. برای تولید نه. به گفتهٔ این تیم، مدلهای زبانی مولدهای احتمالیاند و نه موتور قاعدهٔ قطعی[۳]. مدلی که هزاران بار فیلتر درست را گذاشته، ممکن است یک بار بیصدا آن را جا بیندازد[۳]. ممکن هم هست مقدار فیلتر را از خودش بسازد[۳]. در یک اپلیکیشن مصرفی این بیثباتی آزاردهنده است. در سامانهای چندمستأجری که دادهٔ چند مشتری در یک انبار مینشیند، بهعنوان مرز امنیتی کافی نیست[۳].
راهحل آنها این بود که مرز را از مدل بگیرند و در معماری بگذارند[۳]. سه لایه: امضای رمزنگارانهٔ درخواست، یک لایهٔ اعتبارسنجی معنایی، و جداسازی برنامهای داده در خود پرسوجو[۳]. هر درخواست سه شناسه حمل میکند: مستأجر، کسبوکار و کاربر[۳]. نتیجه باید دقیقاً به همان دامنهٔ مجاز محدود بماند[۳]. لاگ حسابرسی هم هویت کاربر، زمان و جزئیات پرسوجو را ثبت میکند[۳]. راهنمای OWASP با عنوان اختیار بیش از حد (Excessive Agency) همین را به شکل قاعده میگوید[۴]. مجوزدهی را در سیستمهای پاییندست پیاده کنید و تصمیم مجاز بودن یک عمل را به مدل نسپارید[۴].
هر ابزاری که عامل میبیند، یک راه خراب کردن است
توصیههای OWASP در این بخش کوتاه و سختگیرانه است. تعداد ابزارهایی که عامل میتواند صدا بزند را به کمینهٔ لازم برسانید[۴]. کارکرد هر ابزار را هم به کمینهٔ لازم محدود کنید[۴]. از ابزارهای بازپاسخ مثل اجرای هر دستور پوسته یا گرفتن محتوای هر آدرس پرهیز کنید[۴]. مثال خودش برای تیمهای داده آشناست. عاملی که برای پیشنهاد محصول به پایگاه داده وصل میشود، فقط به خواندن جدول محصولات نیاز دارد[۴]. نه به جدولهای دیگر، نه به اجازهٔ درج و بروزرسانی و حذف[۴]. این محدودیت باید با مجوز پایگاه داده اعمال شود، نه با یک جملهٔ دستوری در پرامپت[۴]. برای کارهای پرتأثیر هم تأیید انسانی توصیه شده است[۴].
در سمت پروتکل هم ابزار این محدودسازی وجود دارد. پروتکل زمینهٔ مدل یا MCP استانداردی باز برای وصل کردن دستیارهای هوش مصنوعی به جایی است که داده در آن نگه داشته میشود[۱]. این استاندارد جای یکپارچهسازی سفارشی برای هر منبع را میگیرد[۱]. مستندات پلتفرم Claude، منتشرشده در آوریل ۲۰۲۵، نشان میدهد این محدودسازی در سطح پیکربندی چه شکلی دارد[۲]. میتوان همهٔ ابزارهای یک سرور را فعال کرد[۲]. میتوان فهرست مجاز (allowlist) ساخت و فقط چند ابزار مشخص را روشن گذاشت[۲]. یا ابزارهای ناخواسته را در فهرست ممنوع (denylist) گذاشت[۲]. به توصیهٔ همین مستندات، وقتی دستیار باید فقط خواندنی باشد، بستن ابزارهای نویسنده و مخرب کار درستی است[۲].
یک جزئیات کمدیدهشده هم در همان مستندات هست. سرور MCP میتواند هر زمان فهرست ابزارهایش را عوض کند[۲]. یک قابلیت آزمایشی اجازه میدهد این فهرست سنجاق شود، تا تغییر سمت سرور وسط گفتوگو چیزی را که مدل میبیند عوض نکند[۲]. برداشت ما این است که این نکتهٔ فنی یک پیام مدیریتی دارد: سطح تماس عامل با داده یک قرارداد است و قرارداد نباید بیخبر عوض شود.
سرمایهٔ بعدی تیم داده: مدل قویتر یا قرارداد معنایی
اول چیزی که این شواهد ثابت نمیکنند. هیچکدام از منابع این مقاله عددی دربارهٔ دقت پرسوجوی خودکار نمیدهد. هیچکدام هم نشان نمیدهد لایهٔ معنایی دقت را چند درصد بالا میبرد. آنچه این منابع میسازند استدلال دیگری است: قطعیت و کمینهٔ مجوز را نمیتوان از مدل خواست. پس اگر کسی عنوان میزند لایهٔ معنایی خطای مدل را حل میکند، کمی بیش از شواهد حرف زده است. ادعای دقیقتر این است که لایهٔ معنایی تصمیمهایی را از مدل بیرون میکشد که مدل نباید بگیرد.
فرض کنید یک فروشگاه آنلاین میخواهد عامل داخلیاش به سؤال تعداد مشتری فعال ماه گذشته جواب بدهد. اگر عامل خودش پرسوجو بسازد، در هر نشست میتواند تعریف تازهای از مشتری فعال بسازد. یکبار بر اساس سفارش، یکبار بر اساس ورود به حساب، یکبار با احتساب سفارشهای لغوشده. هیچکدام خطای نحوی نیست؛ همه عددی موجه تولید میکنند و همین خطرناک است. در مقابل، سطح تماس را باریک کنید. عامل فقط سه ابزار ببیند: گرفتن متریک، شکستن آن روی یک بُعد، و اعمال فیلتر. آن وقت تعریف یکبار نوشته میشود و هر پاسخ به همان تعریف ارجاع میدهد. لایهٔ معنایی هدلس، یعنی لایهای که رابط کاربری خودش را ندارد و فقط درگاه میدهد، همین نقش را بازی میکند.
به نظر ما این انتخاب برندهٔ روشنی دارد. تیم دادهٔ کوچکی که چند متریک اصلی را خوب تعریف کرده و پشت ابزارهای محدود گذاشته، با مدل متوسط هم پاسخ قابل اعتماد میدهد. در مقابل، تیمی را ببینید که روی مدل گرانتر سرمایه گذاشته ولی اسکیمای خام را باز گذاشته است. این تیم هر بار باید کل ساختار جدولها را در زمینهٔ مدل بریزد، خروجی را بازبینی کند و پاسخهای متناقض را دستی آشتی بدهد. اثر این روی هزینه دوطرفه است: زمینهٔ کوتاهتر و تلاش دوبارهٔ کمتر، در برابر هزینهٔ یکبارهٔ ساختن قرارداد معنایی.
یک اثر درجه دوم هم به نظر میرسد در راه است. وقتی تعریفها به درگاه تبدیل شوند، کاتالوگ متریک از یک سند داخلی به سطح محصول تیم داده تبدیل میشود. آن وقت تیم داده بیشتر شبیه تیم API کار میکند تا تیم داشبورد. برای مدیر محصول و بازاریابی هم نتیجهٔ عملی روشن است. قبل از وصل کردن عامل به داده، فهرست کنید چه سؤالهایی باید جواب بگیرند. بعد مشخص کنید کدام متریک لازم است و چه کسی مجاز است کدام ردیف را ببیند. بعد همان و فقط همان را به شکل ابزار باز کنید و هر تماس را با هویت کاربر لاگ بگیرید.
| مرز دسترسی | تعریف متریک کجاست | مجوز سطح ردیف | آنچه منابع میگویند |
|---|---|---|---|
| اسکیمای خام و SQL آزاد | داخل مدل، در هر پرسوجو از نو | وابسته به اینکه مدل فیلتر را بگذارد | برای نمونهٔ آزمایشی کار کرد، برای تولید چندمستأجری کافی نبود [S3] |
| ویو و جدول محدود در پایگاه داده | بخشی در ویو، بخشی در مدل | با مجوز پایگاه داده قابل اعمال | محدود کردن مجوز هویت ابزار به کمینهٔ لازم توصیه شده است [S4] |
| ابزارهای محدود روی لایهٔ معنایی | بیرون از مدل، یکبار تعریف | در سیستم پاییندست و مستقل از مدل | فهرست مجاز ابزار و بستن ابزارهای نویسنده در پیکربندی ممکن است [S2] |
خط زمانی
- 2025-04: انتشار مستندات کانکتور MCP پلتفرم Claude با شرح فهرست مجاز، فهرست ممنوع و پیکربندی ابزار به ابزار[۲]
برای کسبوکارهای ایرانی
برای تیمهایی که در ایران با مدلهای کوچکتر یا مدلهای وزنباز روی زیرساخت خودشان کار میکنند، این انتخاب اهمیت بیشتری دارد. هرچه مدل ضعیفتر باشد، باز گذاشتن اسکیمای خام پرهزینهتر است. چون همان مدل باید هم ساختار جدولها را بفهمد و هم تعریف متریک را بسازد. باریک کردن سطح تماس به چند ابزار مشخص، بار فهم را از مدل برمیدارد و زمینهٔ کوتاهتری لازم دارد. یک مزیت دیگر هم قابل حمل بودن است. قرارداد معنایی به یک فروشندهٔ خاص گره نمیخورد. اگر مدل یا ارائهدهنده عوض شود، تعریفها سر جایشان میمانند. برداشت ما این است که سرمایهگذاری روی تعریف متریک و لاگ تماس عامل، کمریسکترین بخش این مسیر برای تیمهای با بودجهٔ محدود است.
چه چیزی را باید دنبال کرد
- آیا فروشندگان ابزارهای تحلیلی، لایهٔ متریک خود را به شکل سرور MCP عرضه میکنند تا عاملها بهجای جدول، متریک صدا بزنند.
- آیا قابلیت سنجاق کردن فهرست ابزار از حالت آزمایشی خارج و به بخش ثابت پیکربندی تبدیل میشود.
- آیا ارزیابیهای عمومی پرسوجوی خودکار شروع میکنند خطای انتخاب جدول و تعریف متریک را از خطای نحوی جدا گزارش کنند.
- آیا لاگ تماس عامل با متریک، در سازمانها به بخشی از حسابرسی دورهای و بررسی انطباق تبدیل میشود.
دادههای مرتبط در همین سایت: دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- Introducing the Model Context Protocol — AnthropicAI، منبع مرجع، دسترسی: 2026-10-01
- MCP connector — Claude Platform Docs، انتشار: 2025-04-04، شواهد تازه، دسترسی: 2026-10-01
- Multi-tenant LLM analytics with row-level security: How we built a secure agent on AWS | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-10-01
- LLM06:2025 Excessive Agency — owasp.org، منبع مرجع، دسترسی: 2026-10-01
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-01.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر