نمرهٔ بنچمارک عمومی کار شما را نمیسنجد: ارزیابی داخلی را به دارایی تبدیل کنید
نمرهٔ بنچمارک عمومی کار شما را نمیسنجد. آلودگی داده، اشباع آزمون و بهینهسازی برای جدول؛ و چرا مجموعهٔ ارزیابی داخلی تنها اهرم تیمهاست.

فهرست مطالب
نمرهٔ یک مدل در جدولهای عمومی تقریباً هیچ چیز دربارهٔ کار شما نمیگوید. بنچمارک (benchmark) یعنی آزمونی استاندارد که همهٔ مدلها را با آن میسنجند و نتیجه را در یک جدول کنار هم میچینند. پژوهشهای موجود سه ضعف را نشان میدهند. نمونههای آزمون به دادهٔ آموزش نشت میکنند و نمره را بالاتر از توان واقعی میبرند[۲]. نزدیک به نیمی از بنچمارکهای پرکاربرد دیگر نمیتوانند مدلهای برتر را از هم تفکیک کنند[۴]. و توسعهدهندگان برای صدرنشینی روی خود آزمون بهینهسازی میکنند[۶]. سازمانی که مدل را از یک فروشنده میخرد، کنترلی روی تغییر نسخهٔ آن ندارد. تنها اهرمی که میماند یک مجموعهٔ ارزیابی داخلی است: نمونههای واقعی از کار خودتان با معیار پذیرش روشن. این مجموعه باید پس از هر تغییر پرامپت یا نسخهٔ مدل دوباره اجرا شود. بدون آن، افت کیفیت را از شکایت مشتری میفهمید، آن هم هفتهها دیرتر.
واقعیتهای کلیدی
- همبستگی رتبهای میان جدول معمول و جدول کنترلشده با بازنویسی پرسشها ۰٫۹۹۷ گزارش شده؛ آلودگی داده نمرهٔ مطلق را بالا میبرد اما ترتیب مدلها را تقریباً جابهجا نمیکند.[۱]
- اثر تصحیحشدهٔ نشت دادهٔ آزمون روی دقت ۰٫۱۸۷ واحد اندازهگیری شده و فقط ۳ مورد از ۱۸۸ ترکیب مدلوبنچمارک آلودگی نامتقارن نشان دادهاند.[۱]
- در بررسی ۶۰ بنچمارک پرکاربرد، نزدیک به نیمی اشباع شدهاند و پنهان نگه داشتن دادهٔ آزمون اثر محافظتی نشان نداده است.[۴]
- دو داور متنباز محلی با نمرهٔ انسانی همبستگی ۰٫۲۷۵ و ۰٫۳۴۰ داشتهاند، در حالی که نرخ ثبات تکرارشان ۹۷٫۳ و ۹۲٫۳ درصد بوده است.[۳]
- SWE-Bench با بیش از ۲٬۰۰۰ مسئلهٔ واقعی از مخازن عمومی ۱۲ پروژهٔ پایتونی منتشر شد؛ مدلهای صدرنشین آن در زبانهای دیگر شکست میخوردند.[۶]
- به گزارش Epoch AI، در FrontierMath Erdős با ۶۸ مسئلهٔ حلنشده، هیچ مدل پیشینی مسئلهای حل نکرده بود و GPT-6 Astra ۲ مسئله را حل کرد؛ نمرهٔ ۳ درصد.[۸]
آلودگی نمره را بالا میبرد، اما ترتیب جدول را عوض نمیکند
آلودگی داده (data contamination) یعنی نمونههای آزمون ناخواسته در دادهٔ آموزش مدل آمده باشند. یک مرور پژوهشی در arXiv توضیح میدهد مدلهای زبانی روی حجم بزرگی از دادهٔ جمعآوریشده از وب آموزش میبینند و این دادهها اغلب با مجموعههای آزمون همپوشانی دارند[۲]. نتیجه ساده است: نمره بالاتر از توان واقعی مدل درمیآید[۲]. پژوهش دیگری در arXiv همین اثر را اندازه گرفته است. نویسندگان پاسخ تکتک نمونهها را برای ۴۷ مدل عمومی و ۷۴ مدل فاینتیونشده با دوز مشخصی از آلودگی روی چهار بنچمارک ARC، GSM8K، HellaSwag و MMLU بررسی کردهاند[۱]. فاینتیون (fine-tuning) یعنی آموزش دوبارهٔ یک مدل آماده با دادهٔ مشخص. اثر تصحیحشدهٔ نشت دادهٔ آزمون ۰٫۱۸۷ واحد دقت گزارش شده است[۱].
همین پژوهش یک تفکیک مهم هم میگذارد. همبستگی رتبهای میان جدول معمول و جدولی که با بازنویسی پرسشها کنترل شده ۰٫۹۹۷ بوده و فقط ۳ مورد از ۱۸۸ ترکیب مدلوبنچمارک آلودگی نامتقارن نشان دادهاند[۱]. پس اگر فقط میخواهید بدانید کدام مدل جلوتر است، ترتیب جدول نسبتاً پایدار میماند[۱]. ولی عدد مطلق به نظر ما بیش از واقع است و نباید مبنای وعده به کسبوکار شود. همان پژوهش پیشنهاد میدهد جدولها رتبهبندی کنترلشده با بازنویسی را همراه با بازهٔ اطمینان منتشر کنند[۱].
آزمونهایی که کهنه میشوند و آزمونهایی که دور زده میشوند
مشکل دوم اشباع است. اشباع یعنی بنچمارک دیگر نمیتواند بهترین مدلها را از هم تفکیک کند و نمرهها در بازهای باریک جمع میشوند[۴]. پژوهشی که ۶۰ بنچمارک متنی پرکاربرد را روی ۱۴ ویژگی بررسی کرده، گزارش میدهد نزدیک به نیمی از آنها اشباع شدهاند و نرخ اشباع با بالا رفتن سن بنچمارک بیشتر میشود[۴]. دو یافتهٔ خلاف انتظار هم دارد: پنهان نگه داشتن دادهٔ آزمون اثر محافظتی نشان نداده، ولی بنچمارکهایی که متخصصها ساختهاند بهتر از نمونههای جمعسپاریشده مقاومت کردهاند[۴].
مشکل سوم بهینهسازی برای آزمون است. SWE-Bench در نوامبر ۲۰۲۴ با بیش از ۲٬۰۰۰ مسئلهٔ واقعی برنامهنویسی از مخازن عمومی ۱۲ پروژهٔ پایتونی منتشر شد[۶]. این آزمون زود به سنجهٔ مرجع معرفی مدلها تبدیل شد[۶]. به گفتهٔ یکی از پژوهشگران سازندهٔ آن، چون مجموعهٔ اولیه فقط پایتون بود، توسعهدهندگان با تمرکز روی پایتون امتیاز میگرفتند[۶]. مدلهای صدرنشین در زبانهای دیگر کاملاً شکست میخوردند[۶]. نمونهٔ دیگر WebArena است، آزمونی روی نسخههای شبیهسازیشدهٔ چند سایت؛ یک مدل برنده در آن از ساختار نشانیهای ردیت بهعنوان میانبر استفاده کرده بود[۶]. یکی از بنیانگذاران OpenAI وضعیت موجود را بحران ارزیابی نامیده است[۶].
جدولهای مبتنی بر رأی انسان هم مصون نیستند. وبلاگ سایمون ویلیسون مرور کرده است که مقالهٔ The Leaderboard Illusion چه ایرادی به آرنای چتبات میگیرد[۷]. به نوشتهٔ آن مقاله، چند فروشندهٔ بزرگ میتوانند چند نسخه را خصوصی آزمایش کنند و بعد فقط بهترین نتیجه را منتشر کنند[۷]. به نقل از همان مقاله، ۲۷ نسخهٔ خصوصی پیش از انتشار Llama-4 آزمایش شده بود[۷]. این مرور میآورد که از ۲۴۳ مدل عمومی، ۲۰۵ مدل بیسروصدا کنار گذاشته شدهاند و حذف بیشتر دامن مدلهای با وزن باز را گرفته است[۷].
ساختن آزمونهای سختتر هم مسئله را از ریشه حل نمیکند. Epoch AI شاخصی به نام ECI دارد که نمرهٔ چند بنچمارک را در یک مقیاس توان عمومی جمع میکند[۸]. به گزارش همین مجموعه، در FrontierMath Erdős که ۶۸ مسئلهٔ حلنشده دارد، هیچ مدل پیشینی هیچ مسئلهای را حل نکرده بود و GPT-6 Astra ۲ مسئله را حل کرد، یعنی نمرهٔ ۳ درصد[۸]. چنین عددی مرز توان مدلها را نشان میدهد، ولی دربارهٔ کار روزمرهٔ یک تیم فروش یا پشتیبانی چیزی نمیگوید.
فاصلهٔ آزمون در خلأ تا عملکرد در جریان کار
یادداشتی در MIT Technology Review استدلال میکند هوش مصنوعی تقریباً هیچوقت به همان شکلی که بنچمارک میشود استفاده نمیشود[۵]. نویسنده از سال ۲۰۲۲ استقرار واقعی این فناوری را در کسبوکارهای کوچک و سازمانهای سلامت، بشردوستانه، غیرانتفاعی و آموزش عالی در بریتانیا، آمریکا و آسیا مطالعه کرده است[۵]. نمونهٔ او رادیولوژی است. برنامههایی که در آزمون سریعتر و دقیقتر از متخصص عمل میکردند، در عمل وقت کارکنان را بیشتر گرفتند[۵]. دلیلش این بود که خروجی باید کنار استانداردهای گزارشدهی همان بیمارستان و الزامات مقرراتی کشور تفسیر میشد[۵]. پیشنهاد آن یادداشت چهار جابهجایی است: از فرد و تکوظیفه به تیم و جریان کار، از آزمون یکباره به اثر بلندمدت، از درستی و سرعت به پیامد سازمانی و قابلیت کشف خطا، و از خروجی منفرد به اثرهای بالادست و پاییندست[۵]. در یکی از نمونههای بخش بشردوستانه، یک سامانه در طول ۱۸ ماه داخل جریان کار واقعی سنجیده شد[۵]. خود یادداشت میپذیرد این شیوه پرهزینهتر و سختتر برای استانداردسازی است[۵].
اجرای مکرر ارزیابی با نیروی انسانی گران است. برای همین بسیاری از تیمها یک مدل را داور میگذارند تا خروجی مدل دیگر را نمره بدهد؛ همان داور مدلمحور (LLM-as-a-judge)[۲]. پژوهشی در arXiv دو داور متنباز محلی را روی ۳۰۰ پاسخ تولیدشده برای ۱۰۰ پرسش در پنج دسته سنجیده است[۳]. ۹ ارزیاب انسانی به پاسخها نمره دادند و هر داور هر پاسخ را سه بار با همان معیار ارزیابی کرد[۳]. همبستگی پیرسون نمرهٔ LLaMA-3-8B با نمرهٔ انسانی ۰٫۲۷۵ و برای Qwen2.5-7B برابر ۰٫۳۴۰ بوده است[۳]. در مقابل، نرخ ثبات دقیق در تکرار ۹۷٫۳ و ۹۲٫۳ درصد گزارش شده است[۳]. جمعبندی نویسندگان روشن است؛ ثبات بالا بهمعنای همراستایی با قضاوت انسان نیست[۳].
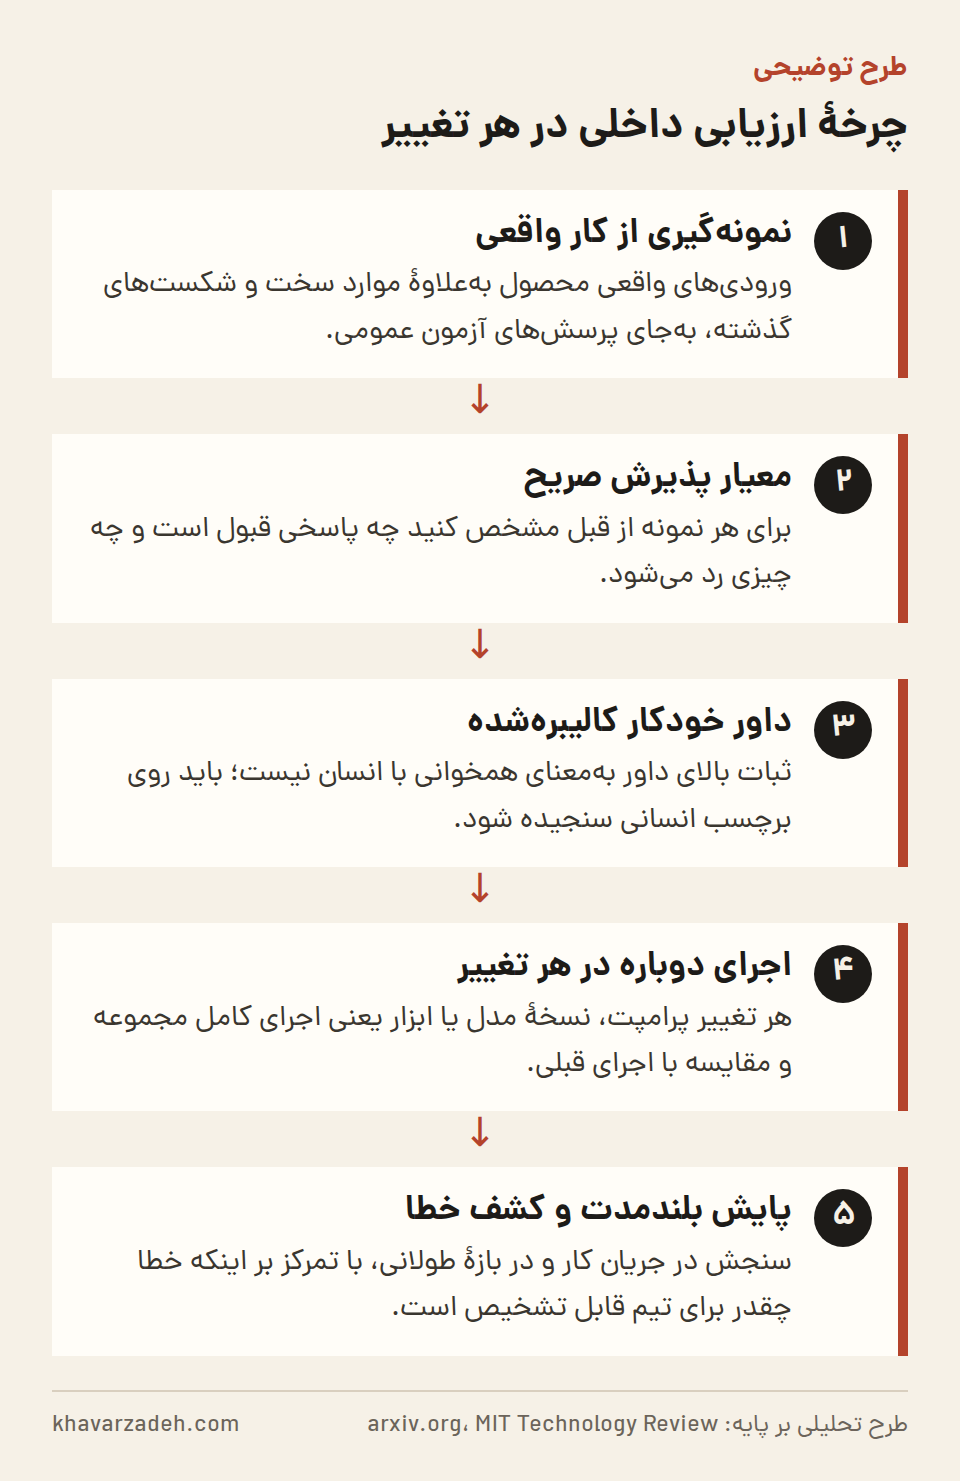
مجموعهٔ ارزیابی داخلی، همان تست رگرسیون شماست
در مهندسی نرمافزار، تست رگرسیون یعنی مجموعهای از آزمونهای ثابت که بعد از هر تغییر دوباره اجرا میشوند تا معلوم شود چیزی خراب نشده است. همین منطق را میتوان روی سامانههای مبتنی بر مدل زبانی پیاده کرد، با این تفاوت که خروجی آنها قطعی نیست و با همان ورودی لزوماً یکسان نمیماند. دارایی شما یک نمرهٔ عمومی نیست؛ پروندهای است از ورودیهای واقعی محصول، همراه با پاسخ قابلقبول و معیار پذیرش صریح برای هر کدام.
فرض کنید یک فروشگاه آنلاین با مدل، توضیح محصول تولید میکند. مجموعهٔ ارزیابی آن میتواند نمونههایی از همهٔ دستههای کالا باشد، بهعلاوهٔ موارد سختی که قبلاً خراب شدهاند. معیار پذیرش باید قابل بررسی باشد، نه سلیقهای؛ مثلاً اینکه عدد مشخصات با منبع بخواند و ادعای ساختگی تولید نشود. هر اجرا هم باید نسخهٔ مدل، متن پرامپت و تنظیمات تولید را کنار نتیجه ثبت کند، وگرنه افت کیفیت به هیچ علتی قابل نسبت دادن نیست. به نظر ما اثر جانبی مهم این کار بیرون از بحث کیفیت است: وقتی تیم معیار پذیرش را روی کاغذ میآورد، تازه معلوم میشود تعریف خروجی خوب در سازمان دقیق نبوده.
| موضوع | آنچه منبع گزارش میکند | عدد کلیدی |
|---|---|---|
| آلودگی داده | نمرهٔ مطلق بالا میرود، ترتیب جدول تقریباً ثابت میماند | همبستگی رتبهای ۰٫۹۹۷ |
| دوز آلودگی | اثر تصحیحشدهٔ نشت دادهٔ آزمون روی دقت | ۰٫۱۸۷ واحد دقت |
| اشباع بنچمارک | نزدیک نیمی از بنچمارکهای بررسیشده قدرت تفکیک خود را از دست دادهاند | ۶۰ بنچمارک بررسیشده |
| داور مدلمحور | ثبات بالا در تکرار، همخوانی کم با نمرهٔ انسانی | همبستگی ۰٫۲۷۵ و ۰٫۳۴۰ |
| حذف مدلها از آرنا | بخش بزرگی از مدلهای عمومی بیاعلام کنار گذاشته شدهاند | ۲۰۵ از ۲۴۳ مدل |
خط زمانی
- 2024-11: SWE-Bench با بیش از ۲٬۰۰۰ مسئلهٔ واقعی برنامهنویسی از ۱۲ پروژهٔ پایتونی منتشر شد و به سنجهٔ مرجع معرفی مدلها تبدیل شد.[۶]
- 2025-05: گزارش MIT Technology Review دربارهٔ بهینهسازی برای بنچمارک و بحث اعتبارسنجی سنجهها منتشر شد.[۶]
- 2026-03: یادداشت MIT Technology Review ارزیابی انسان–هوش مصنوعی در بافت سازمانی و در بازهٔ زمانی طولانی را پیشنهاد کرد.[۵]
برای کسبوکارهای ایرانی
برای تیمهای ایرانی دو نکتهٔ عملی در این بحث هست. اول اینکه ساختن مجموعهٔ ارزیابی داخلی زیرساخت سنگین نمیخواهد؛ دادهٔ آن از لاگ محصول خودتان میآید و هزینهٔ اصلیاش وقت کارشناس است، نه سختافزار. دوم اینکه مدلهای با وزن باز (open-weight، مدلهایی که وزنهایشان در دسترس است و روی سرور خودی اجرا میشوند) گزینهٔ طبیعی برای نقش داور خودکارند. اما همان پژوهش نشان میدهد این داورهای محلی میتوانند بسیار باثبات و در عین حال ناهمراستا با قضاوت انسان باشند[۳]. به نظر میرسد برای کار فارسی این فاصله بیشتر هم باشد، چون جدولهای عمومی زبان و بافت کار شما را نمیسنجند. راه کمریسک این است که چند ده نمونهٔ برچسبخورده بهدست خود تیم مبنای کالیبراسیون داور شود و هر چند وقت یکبار تکرار شود.
چه چیزی را باید دنبال کرد
- آیا جدولهای عمومی رتبهبندی کنترلشده با بازنویسی پرسشها و بازهٔ اطمینان را هم منتشر میکنند؛ این همان چیزی است که پژوهش آلودگی توصیه کرده است[۱].
- آیا بنچمارکهای اشباعشده بازنشسته یا بازبینی میشوند و سنجههای ساختهشده بهدست متخصص جای نمونههای جمعسپاریشده را میگیرند[۴].
- آیا سازمانها سنجههای سطح تیم، بازهٔ زمانی بلند و قابلیت کشف خطا را وارد ارزیابی خرید میکنند[۵].
- در قرارداد با فروشندهٔ مدل، اعلام قبلی تغییر نسخه و امکان ماندن روی نسخهٔ قدیمی را پیگیری کنید؛ بدون آن، مجموعهٔ ارزیابی شما فقط افت را بعد از وقوع نشان میدهد.
منابع
- Contamination Inflates Scores but Rarely Reorders Large Language Model Leaderboards — arXiv.org، منبع مرجع، دسترسی: 2026-10-02
- A Survey on Data Contamination for Large Language Models — arxiv.org، منبع مرجع، دسترسی: 2026-10-02
- When Consistency Does Not Mean Reliability: Evaluating Local LLM Judges Against Human Ratings — arxiv.org، منبع مرجع، دسترسی: 2026-10-02
- When AI Benchmarks Plateau: A Systematic Study of Benchmark Saturation — arxiv.org، منبع مرجع، دسترسی: 2026-10-02
- AI benchmarks are broken. Here’s what we need instead. — MIT Technology Review، انتشار: 2026-03-31، شواهد تازه، دسترسی: 2026-10-02
- How to build a better AI benchmark — MIT Technology Review، انتشار: 2025-05-08، شواهد تازه، دسترسی: 2026-10-02
- Understanding the recent criticism of the Chatbot Arena — Simon Willison’s Weblog، منبع مرجع، دسترسی: 2026-10-02
- AI benchmarks & capabilities — Epoch AI، منبع مرجع، دسترسی: 2026-10-02
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-02.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر