پیش از نمرهدادن به کارشناسها، به داور ماشینی نمره بدهید
مدل زبانی میتواند کیفیت همهٔ مکالمههای پشتیبانی را نمره بدهد، اما نمرههایش تا وقتی با قضاوت انسان سنجیده نشود قابل اتکا نیست.

فهرست مطالب
اگر میخواهید کیفیت مکالمههای پشتیبانی را به یک مدل زبانی بسپارید، کار را از خودِ داور شروع کنید، نه از کارشناسها. این موضوع به مدیر پشتیبانی فروشگاه آنلاین، مدیر عملیات شرکت خدماتی و هر تیمی مربوط است که امروز فقط بخش کوچکی از تماسها و چتها را دستی بازبینی میکند. وسوسه روشن است. بازبینی انسانی گران و کند است و سخت مقیاس میگیرد[۷]. یک مدل اما میتواند به جای نمونه، همهٔ مکالمهها را نمره بدهد. نکته اینجاست که نمرهدادن با مدل خطا دارد و پیش از اجرای انبوه باید با ارزیابی انسانی اعتبارسنجی شود[۵]. تفاوت یک داشبورد کیفیت قابل اتکا با یک داشبورد گمراهکننده، همین مرحلهٔ اعتبارسنجی است.
واقعیتهای کلیدی
- پژوهش پایهای MT-Bench نشان داد داورهای قوی مانند GPT-4 میتوانند ترجیح انسانی را در سطحی هماندازهٔ توافق میان دو ارزیاب انسانی بازتاب دهند.[۱]
- همان پژوهش محدودیتهای داور ماشینی را فهرست کرد: سوگیری موقعیت، سوگیری پرگویی، سوگیری خودبرتربینی و توان استدلال محدود.[۱]
- در یک مطالعهٔ مرجع، ثبات تکرار داورها ۹۷٫۳ و ۹۲٫۳ درصد بود، اما همبستگی پیرسون آنها با نمرهٔ انسان فقط ۰٫۲۷۵ و ۰٫۳۴۰.[۷]
- جابهجایی ترتیب گزینههای کاربرگ نمرهدهی، گزینهٔ برندهٔ اول را در ۱۶ تا ۳۹ درصد درخواستها عوض میکند.[۲]
- راهنمای OpenAI تأکید میکند نمرهدهی با مدل نرخ خطا دارد و باید پیش از اجرای انبوه با ارزیابی انسانی اعتبارسنجی شود.[۵]
- به روایت گزارش InfoQ، دورداش داور مدلی خود را با قضاوت انسانی کالیبره میکند و تنها بعد از آن شبیهساز را روی حجم زیاد مکالمه اجرا میکند.[۶]
کجای کسبوکار شما به کار میآید؟
خدمات مشتری — مدیر پشتیبانی فروشگاه آنلاین یا شرکت خدماتی: میتوانید به جای بازبینی نمونهای مکالمهها، همهٔ چتها و تیکتها را با یک داور مدلی نمره بدهید و از آن فقط برای یافتن موارد مشکوک و دیدن روند هفتگی استفاده کنید، نه برای ارزیابی عملکرد افراد.
قدم اول: یک نمونهٔ کوچک از مکالمههای واقعی را انتخاب کنید و با معیاری روشن به دو سرپرست کیفیت بدهید تا نمره بدهند؛ همین مجموعه سنگمحک داور شما میشود.
زحمت: متوسط · حواستان باشد: نمرهدهی با مدل نرخ خطا دارد و باید پیش از اجرای انبوه با ارزیابی انسانی اعتبارسنجی شود[۵]؛ بدون این مرحله داشبورد شما اطمینان کاذب میسازد.
تحلیل داده — تحلیلگر داده یا مسئول کیفیت: میتوانید توافق داور با انسان را یک سنجهٔ دائمی کنید و در کنار آن ثبات تکرار را هم گزارش دهید، چون این دو چیز جداگانهاند و یکی جای دیگری را نمیگیرد[۷].
قدم اول: همان مجموعهٔ برچسبخوردهٔ انسانی را سه بار به داور بدهید و دو عدد بسازید: اختلاف با نمرهٔ انسان، و میزان تکرارپذیری نمرهٔ خود داور.
زحمت: کم · حواستان باشد: اگر مجموعهٔ آزمون کوچک یا یکدست باشد، عدد توافق خوشبینانه درمیآید؛ موارد حاشیهای و پیامهای مبهم را حتماً وارد کنید[۴].
محصول و فناوری — مدیر محصول مسئول چتبات یا پاسخ خودکار: میتوانید نمرهٔ داور را دروازهٔ انتشار نسخهٔ جدید پرامپت یا مدل کنید: تا وقتی مجموعهٔ آزمون افت نشان میدهد، نسخه منتشر نشود. منطق ارزیابی بازگشت همین است و نرخ قبولی آن باید نزدیک به ۱۰۰ درصد بماند[۳].
قدم اول: چند مورد خرابی واقعی را که ماه گذشته شکایت ساختهاند بنویسید و برای هر کدام یک آزمون قبول یا رد بسازید.
زحمت: متوسط · حواستان باشد: مجموعهٔ آزمون ثابت بهتنهایی رفتار چندمرحلهای عاملها را پوشش نمیدهد و باید با پایش تولید و بازخورد کاربر ترکیب شود[۳].
عملیات و زنجیره تأمین — مدیر عملیات پشتیبانی: میتوانید پیش از تغییر سیاست مرجوعی یا متن پاسخهای آماده، اثر آن را روی مکالمههای شبیهسازیشده بسنجید تا تغییر بدون آزمون به مشتری نرسد. دورداش چنین چرخهای را برای چتبات پشتیبانی خود ساخته است[۶].
قدم اول: یک سناریوی پرتکرار مثل درخواست مرجوعی را انتخاب کنید و چند نسخه از متن پاسخ را روی همان مجموعهٔ آزمون مقایسه کنید.
زحمت: زیاد · حواستان باشد: ساخت شبیهساز به تیم فنی و دسترسی به دادهٔ تاریخی مکالمه نیاز دارد؛ برای تیمهای کوچک، شروع با همان مجموعهٔ طلایی کوچک واقعبینانهتر است.
داور ماشینی چقدر به انسان نزدیک میشود
ایدهٔ داور ماشینی (LLM-as-a-Judge) یعنی یک مدل زبانی به جای ارزیاب انسانی به یک پاسخ نمره بدهد. پژوهش پایهای سال ۲۰۲۳ که معیار MT-Bench را معرفی کرد، این روش را بهصورت نظاممند بررسی کرد[۱]. نتیجه این بود که داورهای قوی مانند GPT-4 ترجیح انسانها را خوب بازتاب میدهند، در سطحی هماندازهٔ توافق میان دو ارزیاب انسانی[۱]. منطق کار هم ساده است: جمعآوری قضاوت انسانی خیلی گران تمام میشود و داوری با مدل راهی مقیاسپذیر برای تقریبزدن آن است[۱].
اما همان پژوهش محدودیتها را هم فهرست کرد: سوگیری موقعیت، سوگیری پرگویی، سوگیری خودبرتربینی و توان استدلال محدود[۱]. یک مطالعهٔ مرجع دیگر توضیح میدهد که مدل میتواند خروجی خودش یا مدلهای نزدیک به خودش را ترجیح بدهد[۲]. راهنمای ارزیابی OpenAI همین هشدار را به سه قاعدهٔ عملی تبدیل کرده است. نمرهدادن با مدل نرخ خطا دارد[۵]. بهتر است مدل داور با مدل پاسخدهنده یکی نباشد[۵]. و پیش از اجرای ارزیابی در مقیاس بزرگ باید عملکرد داور با ارزیابی انسانی اعتبارسنجی شود[۵].
پس آن سطح توافق تضمین شما نیست. آن نتیجه برای مجموعهٔ پرسشها و شرایط همان پژوهش به دست آمده است[۱]. برداشت ما این است که هیچکس از قبل نمیتواند بگوید داور شما روی مکالمههای مرجوعی کالا یا تأخیر ارسال چقدر با سرپرست کیفیت شما همنظر است. این را فقط اندازهگیری روی دادهٔ خودتان مشخص میکند.
ثبات نمره با درستی نمره یکی نیست
خطای رایج این است: تیم یک مکالمه را چند بار به داور میدهد، میبیند نمره تکرار میشود و نتیجه میگیرد داور قابل اعتماد است. یک مطالعهٔ مرجع روی دو داور با وزنهای آزاد (open-weight، یعنی مدلهایی که وزنهایشان در دسترس است و میتوان روی سرور خودتان اجرا کرد) نشان میدهد این استنتاج غلط است[۷]. در آن آزمون، ۳۰۰ پاسخ به ۱۰۰ پرسش هم توسط ۹ ارزیاب انسانی نمره گرفت و هم سه بار توسط هر داور با همان کاربرگ[۷].
نتیجه گویاست. نرخ ثبات دقیق در تکرار برای LLaMA-3-8B برابر ۹۷٫۳ درصد و برای Qwen2.5-7B برابر ۹۲٫۳ درصد بود[۷]. یعنی داورها تقریباً همیشه نمرهٔ قبلی خودشان را تکرار میکردند[۷]. در همان حال، همبستگی پیرسون نمرهٔ آنها با میانگین نمرهٔ انسانها فقط ۰٫۲۷۵ و ۰٫۳۴۰ بود[۷]. جمعبندی خود مقاله این است که ثبات بالا دلیل همخوانی بالا با قضاوت انسان نیست و باید هر دو را سنجید[۷].
برای یک کسبوکار این یعنی داوری که همیشه یک جور نمره میدهد، میتواند همیشه یک جور اشتباه کند؛ چون ثبات در تکرار و همخوانی با انسان دو چیز جدا هستند[۷]. نموداری که هفتهبههفته صاف و بینوسان است حس اطمینان میدهد، ولی ممکن است چیزی را اندازه نگیرد که مشتری تجربه میکند. همینجاست که بحث ارزیابی و تفسیر مدل از یک کار فنی به یک تصمیم مدیریتی تبدیل میشود.
ترتیب گزینهها نمره را جابهجا میکند
فرض کنید برای داور یک کاربرگ نمرهدهی (rubric) نوشتهاید: لحن، درستی اطلاعات، رعایت سیاست مرجوعی، هر کدام با توضیح و دامنهٔ امتیاز. این شکل کار انعطاف خوبی دارد[۲]. اما یک مطالعهٔ مرجع نشان میدهد در عمل شبیه یک آزمون چندگزینهای است و سوگیری موقعیت دارد: مدلها به امتیازهایی تمایل نشان میدهند که در جای خاصی از فهرست آمدهاند[۲]. جهت این سوگیری هم به مدل بستگی دارد؛ بعضی داورها گزینهٔ اول را ترجیح میدهند و بعضی گزینهٔ آخر[۲].
محور دوم سوگیری، ترتیب خودِ معیارها است. وقتی چند معیار در یک درخواست همزمان نمره میگیرند، جابهجایی ترتیب معیارها نمرهٔ نهایی را تغییر میدهد[۲]. اثر آن در عمل کم نیست: تنها عوضکردن ترتیب کاربرگ، گزینهٔ برندهٔ اول را در ۱۶ تا ۳۹ درصد درخواستها عوض میکند[۲]. خبر خوب اینکه راهحل پیچیدهای لازم نیست؛ تعداد کمی ترتیب تصادفی برای کاهش این خطا در بیشتر مدلها کافی است[۲].
این یافته یک قاعدهٔ ساده به تیم کیفیت میدهد. پیش از اعتماد به تفاوت نمرهٔ دو کارشناس یا دو نسخهٔ پرامپت، ترتیب گزینهها را جابهجا کنید و ببینید تفاوت باقی میماند یا نه؛ چون همین جابهجایی در بخشی از موارد برندهٔ اول را عوض میکند[۲]. اگر تفاوت باقی نماند، خاصیت داور بوده، نه خاصیت پاسخ.
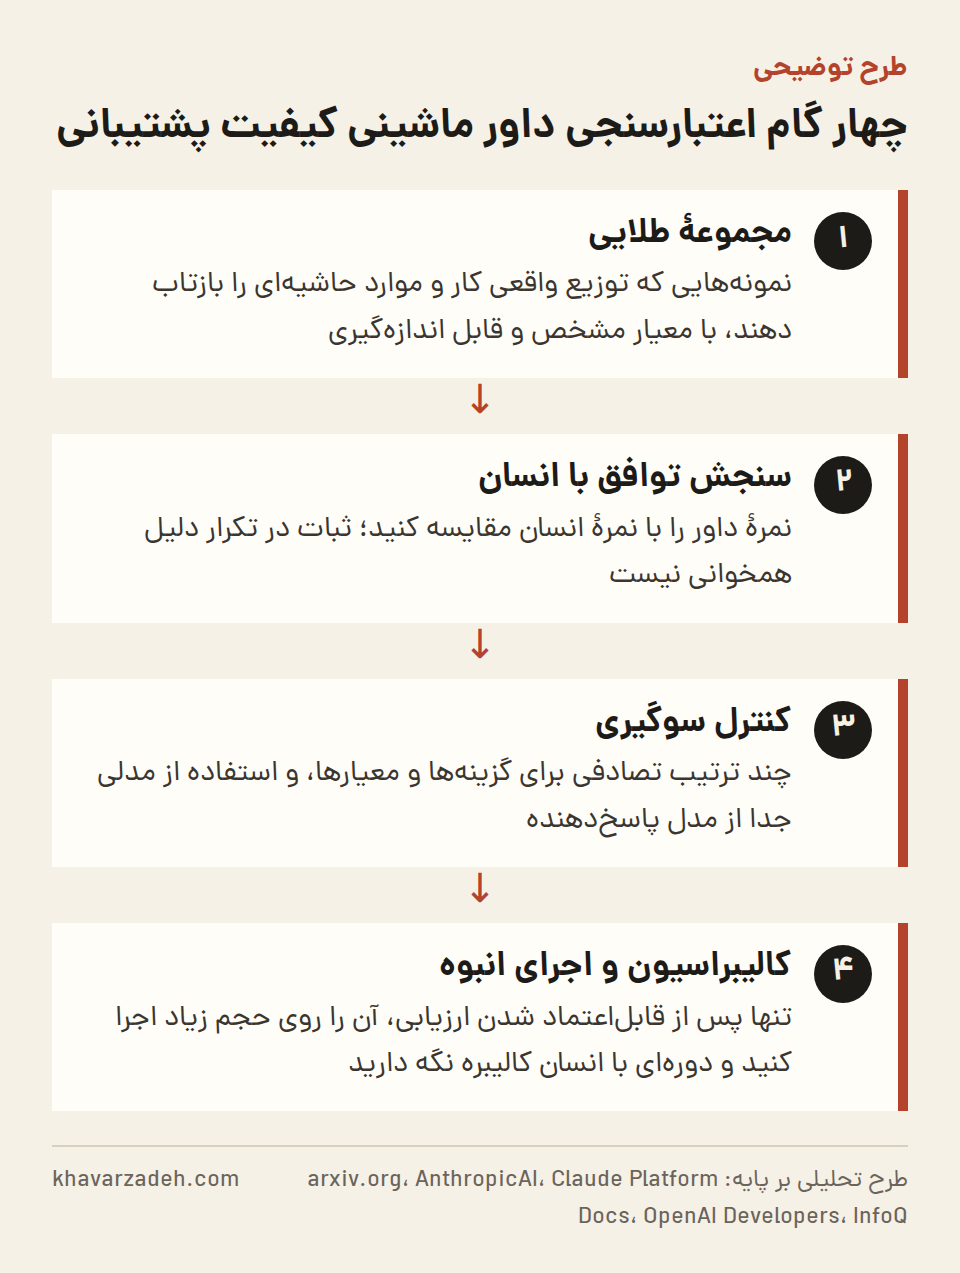
از داور معتبر چه بخواهیم و چه نخواهیم
Anthropic در توضیحهایش دربارهٔ ارزیابی عاملها نمرهدهندهها را سه دسته میکند: کدمحور، مدلمحور و انسانی[۳]. در همان نوشته، تیم Descript برای عامل ویرایش ویدئو از نمرهدهی دستی به نمرهدهندهٔ مدلی رسیده است؛ معیارها را تیم محصول تعریف کرد و کالیبراسیون انسانی دورهای انجام میشود[۳]. نمونهٔ دوم تیم Bolt AI است که در ۳ ماه سامانهٔ ارزیابی خود را ساخت، با داور مدلی برای رفتارهایی مثل پیروی از دستور[۳].
گزارش InfoQ نمونهٔ تازهتری از پشتیبانی مشتری میآورد. دورداش برای آزمودن چتبات پشتیبانی خود یک شبیهساز مکالمه ساخته است و در چند دقیقه صدها مکالمهٔ شبیهسازیشده اجرا میکند[۶]. ترتیب کار در آن چرخه همان چیزی است که این مقاله استدلال میکند. اول یک مورد خرابی شناسایی میشود[۶]. بعد یک ارزیابی داور مدلی برای تشخیص آن ساخته و با قضاوت انسانی کالیبره میشود[۶]. تنها وقتی آن ارزیابی قابل اعتماد شد، شبیهساز مکالمهها را تولید میکند[۶]. طبق همان گزارش، بهبود مدیریت زمینه که با این چارچوب اعتبارسنجی شد، نرخ توهم را پیش از استقرار حدود ۹۰ درصد کم کرد[۶].
دو نکته دربارهٔ مجموعهٔ طلایی. راهنمای Anthropic میگوید معیار موفقیت باید مشخص و قابل اندازهگیری باشد و نمونهها توزیع واقعی کار را بازتاب دهند، از جمله موارد حاشیهای مثل ورودی بیربط یا پیام بسیار طولانی[۴]. همان راهنما توصیه میکند حجم را بر کیفیت مقدم بدانید: پرسش بیشتر با نمرهدهی خودکار بهتر از تعداد کم با نمرهدهی کامل انسانی است[۴].
جمعبندی ما تفسیر است، نه نقل از منابع. داور اعتبارسنجیشده برای دو کار خوب است: پایش روند، و دروازهٔ انتشار. دروازهٔ انتشار یعنی نسخهٔ جدید پرامپت یا مدل تا وقتی نمرهٔ مجموعهٔ آزمون افت دارد منتشر نشود. منطق ارزیابی بازگشت همین است و نرخ قبولی آن باید نزدیک به ۱۰۰ درصد بماند[۳]. در مقابل، استفاده از نمرهٔ داور برای حقوق، پاداش یا ارتقای کارشناس به نظر ما اشتباه است. وقتی همبستگی داور با انسان در یک مطالعهٔ مرجع در حد ۰٫۲۷۵ و ۰٫۳۴۰ دیده شده[۷]، نمرهای که سرنوشت شغلی تعیین میکند دقت کافی ندارد. اثر جانبی احتمالی هم این است که کارشناسها یاد میگیرند برای سلیقهٔ داور بنویسند؛ مثلاً پاسخ را طولانیتر کنند، چون داورها به پاسخهای طولانیتر و پرگوتر نمرهٔ بالاتری میدهند[۲].
| سنجه | LLaMA-3-8B | Qwen2.5-7B |
|---|---|---|
| همبستگی پیرسون با میانگین نمرهٔ انسان | ۰٫۲۷۵ | ۰٫۳۴۰ |
| میانگین خطای مطلق (MAE) | ۲۷٫۷۱ | ۱۸٫۶۴ |
| نرخ ثبات دقیق در تکرار نمرهدهی | ۹۷٫۳ درصد | ۹۲٫۳ درصد |
خط زمانی
- 2023-06: انتشار پژوهش MT-Bench و Chatbot Arena با نخستین بررسی نظاممند داور ماشینی و سوگیریهای آن[۱]
- 2024-03: راهنمای OpenAI Evals: نمرهدهی با مدل خطا دارد و باید پیش از مقیاسدادن با انسان اعتبارسنجی شود[۵]
- 2026-03: گزارش ساخت شبیهساز مکالمه در دورداش با داور مدلی کالیبرهشده با قضاوت انسانی[۶]
برای کسبوکارهای ایرانی
برای تیمهای ایرانی دو نکتهٔ عملی در این بحث هست. اول اینکه بخش گرانقیمت این کار مدل نیست، مجموعهٔ طلایی است: مجموعهای از مکالمههای واقعی که سرپرست کیفیت خودتان با معیار روشن نمره داده باشد. آن دارایی به هیچ سرویس خارجی وابسته نیست و با تغییر مدل هم از بین نمیرود. دوم اینکه اگر دسترسی به مدلهای تجاری محدود یا پرهزینه است، داور با وزنهای آزاد روی سرور داخلی یک گزینهٔ واقعی است. فقط انتظارتان را درست تنظیم کنید؛ یک مطالعهٔ مرجع روی دو داور از این خانواده همخوانی محدودی با نمرهٔ انسان نشان داده است[۷]. برداشت ما این است که چنین داوری برای دیدن روند و گرفتن علامت هشدار روی حجم زیاد مکالمه میتواند کافی باشد، ولی برای قضاوت دربارهٔ عملکرد افراد نه. مزیت جانبی اجرای محلی هم این است که متن مکالمهٔ مشتری از سازمان خارج نمیشود.
چه چیزی را باید دنبال کرد
- عدد توافق داور شما با سرپرست کیفیت روی مجموعهٔ طلایی؛ اگر این عدد را ندارید، هیچ نمرهٔ دیگری معنا ندارد
- پایداری نتیجه پس از جابهجاکردن ترتیب گزینهها و معیارها در کاربرگ نمرهدهی[۲]
- انتشار مطالعههای تازهتر دربارهٔ همخوانی داورهای با وزنهای آزاد با قضاوت انسان، چون شواهد فعلی به مدل و وظیفه حساس است[۷]
- گزارشهای میدانی بیشتر از پشتیبانی مشتری که ترتیب کالیبراسیون انسانی پیش از اجرای انبوه را مستند میکنند[۶]
منابع
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena — arXiv.org، انتشار: 2023-06-09، مرجع پایه، دسترسی: 2026-10-02
- Am I More Pointwise or Pairwise? Revealing Position Bias in Rubric-Based LLM-as-a-Judge — arxiv.org، منبع مرجع، دسترسی: 2026-10-04
- Demystifying evals for AI agents — AnthropicAI، منبع مرجع، دسترسی: 2026-10-02
- Define success criteria and build evaluations — Claude Platform Docs، منبع مرجع، دسترسی: 2026-10-04
- Getting Started with OpenAI Evals — OpenAI Developers، انتشار: 2024-03-26، مرجع پایه، دسترسی: 2026-10-04
- DoorDash Builds LLM Conversation Simulator to Test Customer Support Chatbots at Scale — InfoQ، انتشار: 2026-03-13، شواهد تازه، دسترسی: 2026-10-04
- When Consistency Does Not Mean Reliability: Evaluating Local LLM Judges Against Human Ratings — arxiv.org، منبع مرجع، دسترسی: 2026-10-04
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-10-04.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر