اسناد پرونده نیویورک تایمز: وقتی مدل زبانی زنجیره تأمین محتوای خودش را فرسوده میکند
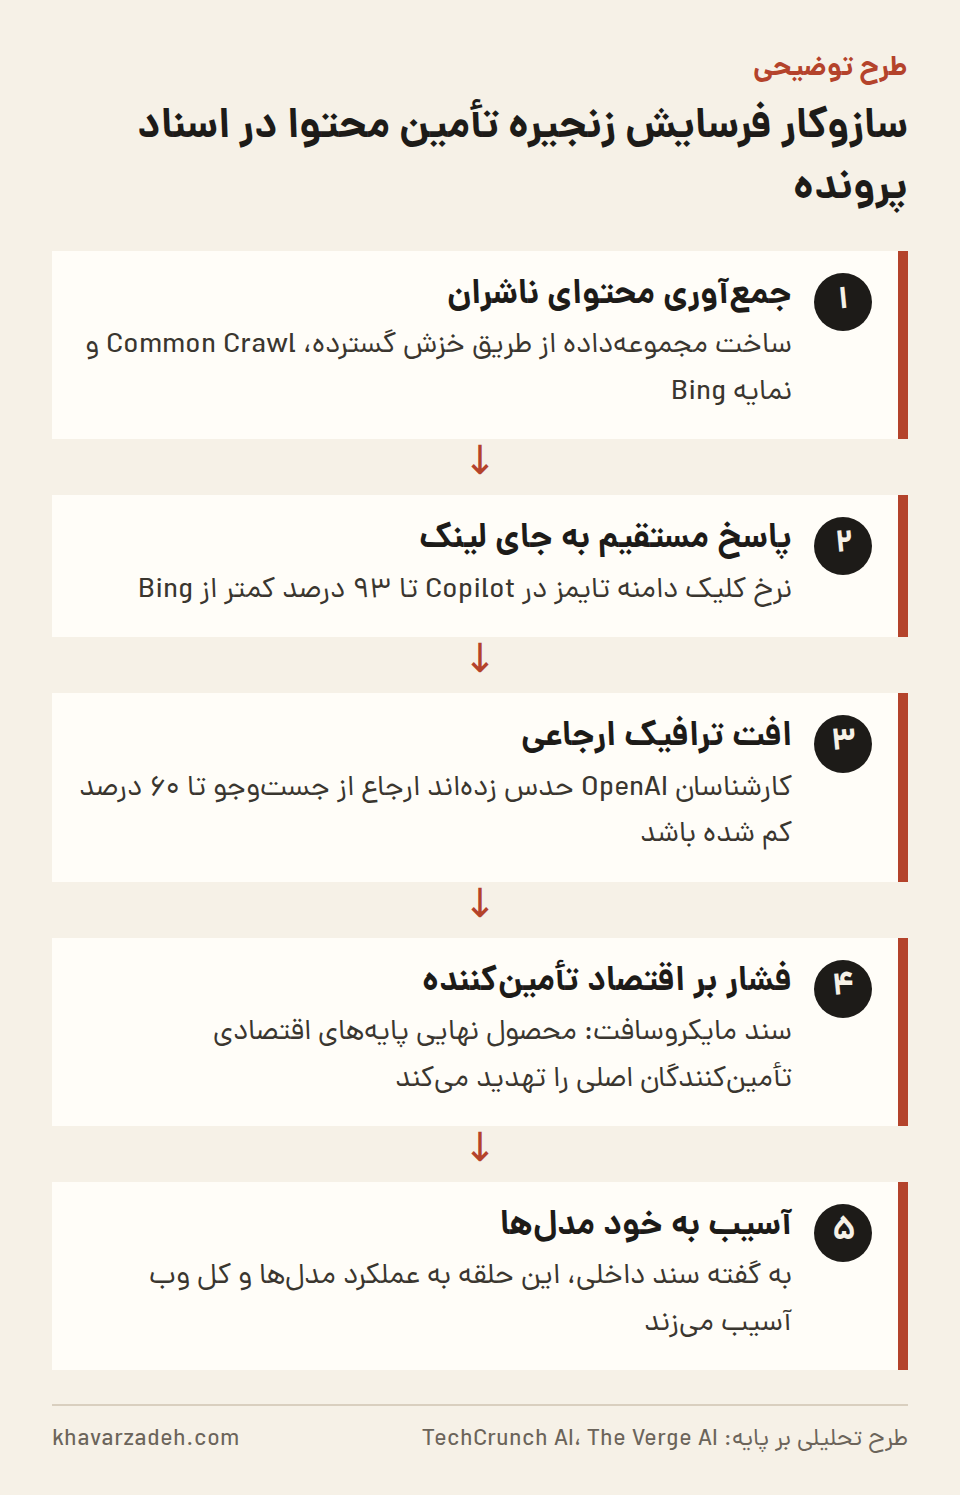
اسناد تازه در پرونده نیویورک تایمز علیه OpenAI و مایکروسافت نشان میدهد نرخ کلیک ناشر در Copilot تا ۹۳ درصد کمتر از Bing بوده است.
فهرست مطالب
اسناد تازهای که در پرونده کپیرایت نیویورک تایمز علیه OpenAI و مایکروسافت از حالت محرمانه خارج شده، نشان میدهد این دو شرکت در مکاتبات داخلی خود از خطر محصولاتشان برای ناشران آگاه بودهاند[۱][۲]. به گزارش TechCrunch، یک مدیر ارشد مایکروسافت در یادداشتی داخلی شیوه جمعآوری داده برای آموزش مدلها را بزرگترین سرقت کار در تاریخ بشر توصیف کرده است[۱]. دادههای خود مایکروسافت هم نشان میدهد نرخ کلیک به دامنه نیویورک تایمز در موتور پاسخ Copilot تا ۹۳ درصد کمتر از جستوجوی سنتی Bing بوده است[۱]. اهمیت این پرونده برای تصمیمگیران فراتر از دادگاه است. به نظر میرسد سازندگان مدلهای زبانی مدتها پیش مسئلهای را صورتبندی کرده بودند که امروز مدل کسبوکار ناشران و بازاریابی متکی بر ترافیک جستوجو را تهدید میکند: محصولی که منبع مواد اولیه خودش را فرسوده میکند. پیش از هر نتیجهگیری باید یادآوری کرد که بخش زیادی از این اطلاعات از لایحه خود نیویورک تایمز آمده و مستندات اصلی همچنان مهر و موم است[۱].
واقعیتهای کلیدی
- به گزارش TechCrunch، طبق دادههای مایکروسافت نرخ کلیک به دامنه نیویورک تایمز در Copilot تا ۹۳ درصد کمتر از جستوجوی سنتی Bing بوده است.[۱]
- مجموعهدادههای میانآموزش OpenAI بیش از ۹۱٬۶۹۲ نسخه از آثار سه ناشر شاکی را دارد.[۱]
- مجموعهداده Project Mango دستکم ۱۶۰٬۹۰۳ اثر یکتا از ناشران خبری را شامل میشده است.[۱]
- کارشناسان OpenAI حدس زدهاند ترافیک ارجاعی از جستوجو تا ۶۰ درصد کاهش یافته باشد.[۲]
- مایکروسافت میگوید اظهارات برنت هکت دیدگاه شخصی او است و موضع شرکت نیست.[۲]
- بیشتر اطلاعات تازه از لایحه نیویورک تایمز آمده و مستندات پیوست هنوز مهر و موم است.[۱]
اسناد چه میگویند و چه چیزی را هنوز ثابت نمیکنند
به گزارش TechCrunch، این اسناد برای نخستین بار نشان میدهد که فقط مجموعهدادههای میانآموزش OpenAI بیش از ۹۱٬۶۹۲ نسخه از آثار نیویورک تایمز، دیلی نیوز و مرکز گزارشگری تحقیقی را در خود دارد[۱]. یک مجموعهداده برگرفته از Common Crawl هم بهتنهایی بیش از ۲ میلیون سند از دامنه nytimes.com داشته است[۱]. طبق لایحه، مایکروسافت از طریق طرحهایی به نام Project Taxi و Project Mango به OpenAI داده آموزشی داده و مجموعهداده Mango دستکم ۱۶۰٬۹۰۳ اثر یکتا از این ناشران را شامل میشده است[۱]. ادعاهای دیگر لایحه عبارتاند از دور زدن دیوار پرداخت بدون شناسایی شدن و حذف عمدی اعلانهای کپیرایت از داده آموزشی[۱].
به گزارش The Verge، کارکنان OpenAI در داخل شرکت پذیرفته بودند که GPT-4 حجم زیادی از داده را به خاطر سپرده و در بازتولید متن بسیار توانمند است[۲]. لایحه نمونههایی از خروجی ChatGPT را آورده که رشتههای طولانی متن مقالههای تایمز و چند رسانه دیگر را عیناً تکرار میکند[۲]. همچنین یک نماینده OpenAI گفته از هیچ تلاشی برای شناسایی یا حذف محتوای پشت دیوار پرداخت از داده آموزشی خبر نداشته است[۲].
با این حال، این شواهد محدودیت جدی دارند. TechCrunch تأکید میکند که بیشتر اطلاعات تازه از لایحه تایمز آمده، نه از مستندات پیوست، و نقلقولها بدون بافت اصلیشان منتشر شدهاند[۱]. سخنگوی مایکروسافت به The Verge گفته اظهارات برنت هکت، مدیر علوم کاربردی این شرکت، دیدگاه شخصی یک کارمند است و موضع شرکت یا تحلیل حقوقی به شمار نمیرود[۲]. به گزارش TechCrunch، قاضیها تاکنون عمدتاً با استدلال شرکتهای هوش مصنوعی درباره استفاده منصفانه همراهی کردهاند[۱].
اقتصاد محصولی که تأمینکنندهاش را جایگزین میکند
مهمترین بخش پرونده از نگاه کسبوکار، دادههای مربوط به ترافیک است، نه عبارتهای تند. هکت در ارائهای داخلی در ژانویه ۲۰۲۴ افت نرخ کلیک را حلقهای مخرب توصیف کرده که هم به عملکرد مدلهای شرکت آسیب میزند و هم به کل وب[۱]. در همین سند آمده که کمتر پیش میآید یک محصول نهایی پایههای اقتصادی تأمینکنندگان اصلی خودش را تهدید کند، اما مایکروسافت چنین وضعیتی را برای کسبوکار مدلهای زبانیاش در زنجیره تأمین محتوا ایجاد کرده است[۱]. به گزارش The Verge، مایکروسافت در جای دیگری نوشته مدلهای زبانی محصولیاند که زنجیره تأمین خودشان را نابود میکنند[۲].
طرف OpenAI هم تصویر مشابهی دارد. به گزارش TechCrunch، نیک ترلی، مدیر ChatGPT، در مکاتبات داخلی نوشته که ناشران با تهدیدی وجودی روبهرو هستند، چون این محصولات تا حد زیادی جایگزین منبع میشوند و با بهتر شدن، این خاصیت بیشتر میشود[۱]. او به گفته The Verge گفته بود وقتی کاربر پاسخ را از چتبات گرفت، دلیل خوبی برای کلیک روی لینک منبع نمیماند[۲]. کارشناسان رسانه و اقتصاد OpenAI هم افت ترافیک ارجاعی سایتهایی مثل تایمز را به خلاصههای هوش مصنوعی مانند AI Overviews گوگل نسبت داده و حدس زدهاند که ارجاع از جستوجو تا ۶۰ درصد کاهش یافته باشد[۲].
این موضوع از نظر حقوقی هم اهمیت دارد، چون یکی از شروط استفاده منصفانه این است که استفاده، جایگزین اثر اصلی نشود و به بازار آن آسیب نزند[۱]. ساتیا نادلا، مدیرعامل مایکروسافت، در شهادتی در اوایل امسال گفته هر محتوای پشت دیوار پرداخت باید برای آموزش یا گراندینگ مجوز داشته باشد[۱]. سخنگوی مایکروسافت هم گفته شهادت نادلا با موضع شرکت در این پرونده سازگار است[۲].
برندگان، بازندگان و درس عملی برای تیمهای محصول و داده
برداشت ما این است که تیتر سرقت، کمی ماجرا را بزرگتر از آنچه اسناد ثابت میکنند نشان میدهد. این عبارت از یک فرد آمده که شرکتش خود را از او جدا کرده و حکم دادگاه هم هنوز صادر نشده است. خبر واقعی جای دیگری است: دادههای داخلی خود شرکتها نشان میدهد که الگوی پاسخ مستقیم، مسیر کاربر به سمت منبع را کوتاه میکند. این یافته حتی اگر پرونده به نفع OpenAI و مایکروسافت تمام شود، به قوت خود باقی میماند.
بازنده مستقیم این وضعیت، مدلهای کسبوکاری است که درآمدشان به کلیک وابسته است، مثل تبلیغات نمایشی، سئوی محتوایی و بازاریابی ورودی. در مقابل، دارندگان محتوای انحصاری و بهروز میتوانند قدرت چانهزنی بیشتری پیدا کنند، بهویژه اگر پروندههایی از این دست هزینه استفاده بدون مجوز را بالا ببرد. اثر مرتبه دوم احتمالی هم این است که ناشران محتوای بیشتری را پشت دیوار پرداخت ببرند یا دسترسی خزندهها را ببندند. در آن صورت، داده باکیفیت و تازه برای آموزش مدلها کمیابتر و گرانتر میشود و هزینه مجوز محتوا میتواند به جزء ثابتی از ساختار هزینه شرکتهای هوش مصنوعی تبدیل شود.
برای تیمهای بازاریابی، درس عملی این است که جستوجوی بدون کلیک را جدی بگیرند. سهم ترافیک ارجاعی را جداگانه بسنجند، حضور برند در پاسخهای هوش مصنوعی را پایش کنند و به کانالهای مستقیم مثل خبرنامه و اشتراک بیشتر تکیه کنند. تیمهای داده و محصولی که مدل آموزش میدهند یا بازآموزی میکنند هم بهتر است منشأ هر مجموعهداده، وضعیت مجوز و فراداده کپیرایت را مستند کنند. اگر حذف اعلانهای کپیرایت در دادگاه به عنوان شاهدی علیه شرکتها استفاده شود، مستندسازی منشأ داده دیگر یک کار حاشیهای نیست و به بخشی از مدیریت ریسک محصول تبدیل میشود.
| شاخص | مقدار | توضیح |
|---|---|---|
| افت نرخ کلیک دامنه تایمز در Copilot نسبت به Bing | تا ۹۳ درصد | داده خود مایکروسافت به نقل از لایحه |
| نسخههای آثار سه ناشر در دادههای میانآموزش OpenAI | بیش از ۹۱٬۶۹۲ | نیویورک تایمز، دیلی نیوز، مرکز گزارشگری تحقیقی |
| اسناد nytimes.com در یک مجموعهداده برگرفته از Common Crawl | بیش از ۲ میلیون | یک مجموعهداده |
| آثار یکتای ناشران در مجموعهداده Project Mango | دستکم ۱۶۰٬۹۰۳ | ادعای لایحه |
| کاهش ترافیک ارجاعی از جستوجو | تا ۶۰ درصد | برآورد حدسی کارشناسان OpenAI |
خط زمانی
- 2023-01: یادداشت داخلی برنت هکت در مایکروسافت که جمعآوری داده را سرقت کار توصیف میکند[۱]
- 2024-01: ارائه داخلی هکت درباره افت نرخ کلیک و حلقه مخرب برای مدلها و وب[۱]
- 2026-09-17: انتشار گزارش TechCrunch درباره اطلاعات تازه از حالت محرمانه خارجشده در پرونده نیویورک تایمز[۱]
- 2026-09-18: گزارش The Verge به همراه موضع سخنگوی مایکروسافت درباره اظهارات هکت و شهادت نادلا[۲]
برای کسبوکارهای ایرانی
برای ناشران و سایتهای محتوایی فارسیزبان که بخش بزرگی از ترافیکشان از جستوجو میآید، این پرونده میتواند یادآوری عملی باشد که سنجش جداگانه سهم ترافیک ارجاعی و تقویت کانالهای مستقیم، مثل خبرنامه و عضویت، اهمیت بیشتری پیدا کرده است. تیمهایی که با مدلهای متنباز روی داده وب فارسی مدل تنظیم یا بازآموزی میکنند هم احتمالاً از مستندسازی منشأ داده و نگه داشتن فراداده مجوز سود میبرند، بهویژه اگر محصولشان روزی به بازارهای خارجی برسد.
چه چیزی را باید دنبال کرد
- آیا مستندات پیوست پرونده که هنوز مهر و موم است منتشر میشود و بافت اصلی نقلقولها را روشن میکند؟
- اینکه دادگاه دادههای افت نرخ کلیک را در سنجش آسیب به بازار اثر اصلی، به عنوان یکی از شروط استفاده منصفانه، چقدر مهم میداند.
- آیا ناشران بیشتری دسترسی خزندهها را محدود میکنند یا محتوای بیشتری را پشت دیوار پرداخت میبرند؟
- اینکه شرکتهای هوش مصنوعی مدل مجوز محتوا برای آموزش و گراندینگ را گسترش میدهند یا نه.
دادههای مرتبط در همین سایت: دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- Microsoft exec called AI scraping ‘the largest theft of labor in human history,' new unredacted filings reveal | TechCrunch — TechCrunch AI، انتشار: 2026-09-17، دسترسی: 2026-09-18
- OpenAI and Microsoft knew they were starting a ‘doom loop’ for the web — The Verge AI، انتشار: 2026-09-18، دسترسی: 2026-09-18
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-19.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر