مسیریابی مدلهای زبانی: صرفهجویی از مدل ارزان نمیآید، از دانستن زمان شکست آن میآید
روترهای مدل زبانی هزینه را کم میکنند، اما صرفهجویی واقعی به داده ارزیابی و تعریف کیفیت در سطح هر وظیفه وابسته است، نه فقط به الگوریتم مسیریابی.
فهرست مطالب
مسیریابی مدلها دیگر فقط یک ایده پژوهشی نیست و به محصولی مدیریتشده در سرویسهای ابری تبدیل شده است. آمازون قابلیت Intelligent Prompt Routing را در Bedrock بهصورت عمومی در دسترس قرار داده است[۷]. مایکروسافت هم در Foundry روتری ارائه میدهد که هر پرامپت را بر اساس پیچیدگی، نیاز به استدلال و نوع وظیفه تحلیل میکند و یکی از مدلهای زیربنایی را برایش برمیگزیند[۸]. مدیر مالی و مدیر محصول یک پرسش مشترک دارند: آیا هزینه واقعاً کم میشود بیآنکه کیفیت پاسخ پایین بیاید؟ برداشت ما از منابع این است که پاسخ مثبت است، اما شرط دارد. هر عدد صرفهجویی که منتشر شده، با یک تعریف مشخص از کیفیت و روی یک مجموعه ارزیابی مشخص سنجیده شده است. اگر آن تعریف با وظیفه واقعی سازمان جور نباشد، بخشی از صرفهجویی ممکن است در واقع افت کیفیتی باشد که کسی آن را اندازه نمیگیرد. به همین دلیل به نظر میرسد ارزش مسیریابی بیشتر به داده ارزیابی و تعریف کیفیت برای هر وظیفه بستگی دارد تا به خود الگوریتمی که مدل را انتخاب میکند.
واقعیتهای کلیدی
- RouteLLM در برخی موارد هزینه را روی بنچمارکهای شناختهشده بیش از ۲ برابر کاهش داد، بیآنکه کیفیت پاسخ افت کند.[۱]
- به ادعای نویسندگان FrugalGPT، هزینه تا ۹۸ درصد کاهش مییابد و عملکرد همچنان همسطح بهترین مدل منفرد میماند.[۲]
- آمازون صرفهجویی ۳۵، ۵۶ و ۱۶ درصدی را به ترتیب برای خانوادههای Nova، Anthropic و Meta گزارش کرده که فقط در داخل هر خانواده قابل مقایسه است.[۶]
- مسیریابی Bedrock فقط برای پرامپتهای انگلیسی بهینه شده است و نمیتواند تصمیمهایش را با داده عملکرد اختصاصی برنامه تنظیم کند.[۵]
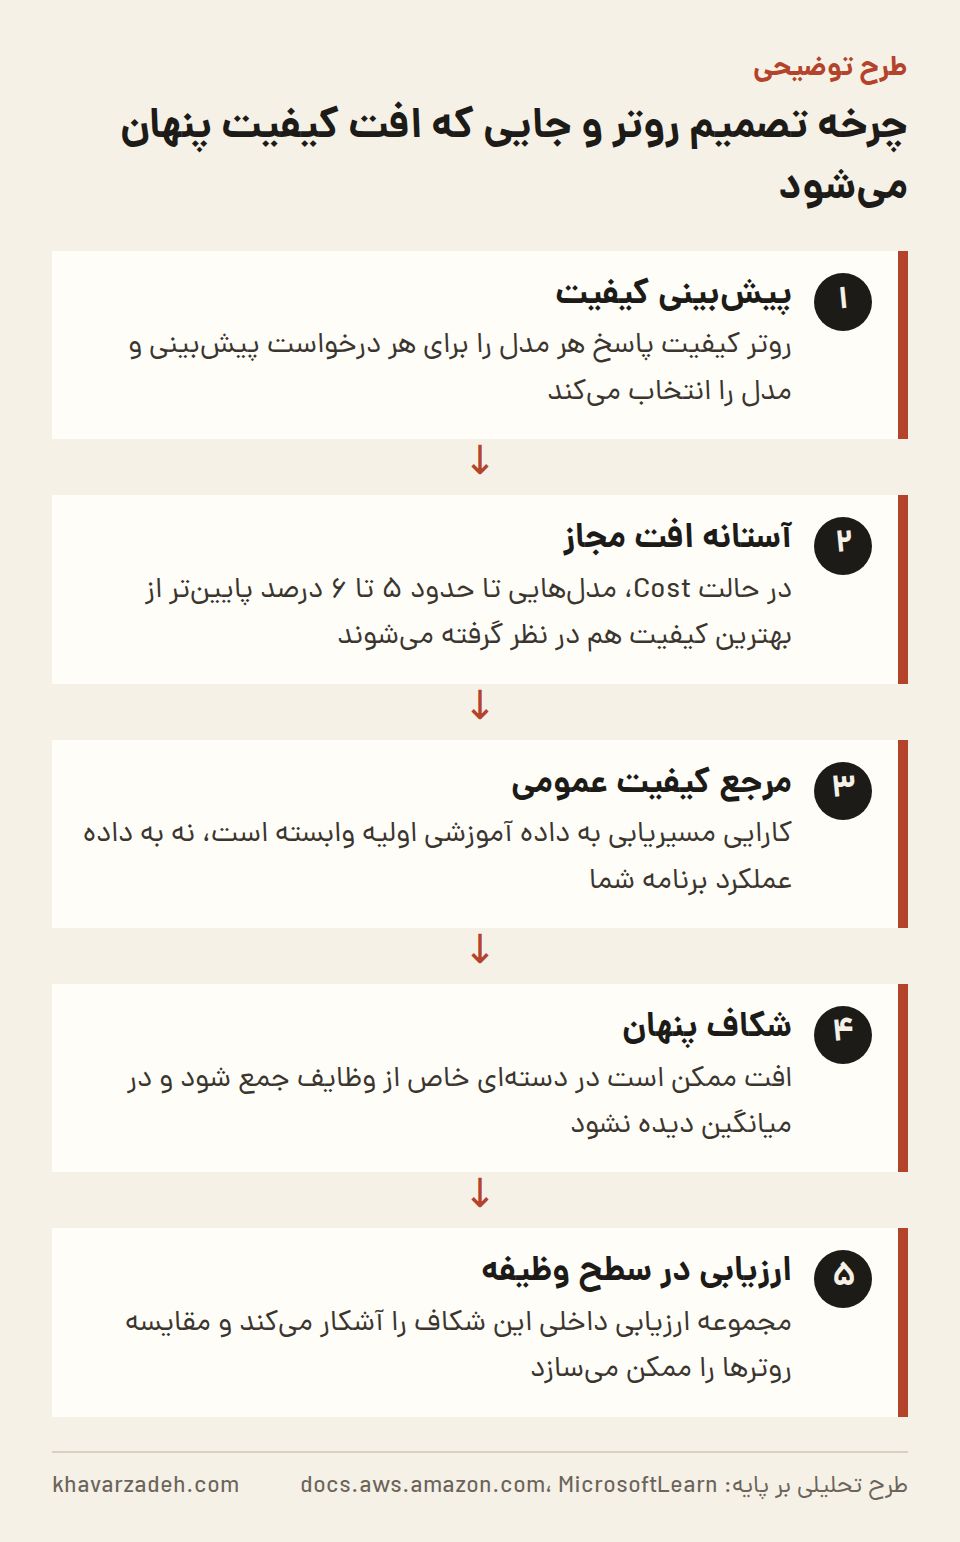
- در حالت Cost روتر مایکروسافت، مدلهایی که تا حدود ۵ تا ۶ درصد با بهترین کیفیت فاصله دارند هم در انتخاب شرکت داده میشوند.[۸]
شواهد پایه: صرفهجویی همیشه روی یک مجموعه ارزیابی سنجیده شده است
پژوهش پایهای RouteLLM که نسخه نخستش در ژوئن ۲۰۲۴ منتشر شد، روترهایی را معرفی کرد که هنگام استنتاج میان یک مدل قویتر و یک مدل ضعیفتر انتخاب میکنند و با داده ترجیحات انسانی آموزش دیدهاند[۱]. به گزارش نویسندگان، این روش روی بنچمارکهای شناختهشده در برخی موارد هزینه را بیش از ۲ برابر کاهش داد، بیآنکه کیفیت پاسخ افت کند[۱]. همین پژوهش نشان داد که روترها حتی وقتی مدل قوی و ضعیف در زمان آزمون عوض میشدند، عملکردشان را حفظ کردند[۱].
مقاله FrugalGPT از زاویه اقتصادی به موضوع نگاه میکند و نشان میدهد تفاوت قیمت APIهای مدلهای زبانی به ۲ مرتبه بزرگی میرسد[۲]. نویسندگانش ۳ راهبرد برای کاهش هزینه برمیشمارند که یکی از آنها زنجیره آبشاری مدلهاست[۲]. به ادعای آنها، FrugalGPT میتواند با کاهش هزینه تا ۹۸ درصد به عملکرد بهترین مدل منفرد برسد، یا با همان هزینه دقت را ۴ درصد بالاتر ببرد[۲].
مسئله سنجش هم از همان ابتدا مطرح بوده است. طبق مقاله RouterBench، نبود یک بنچمارک استاندارد برای ارزیابی روترها پیشرفت این حوزه را کند کرده بود[۳]. این مقاله برای رفع این کمبود یک چارچوب ارزیابی و مجموعهدادهای بزرگ از نتایج استنتاج مدلهای شاخص ارائه میکند[۳]. یک مرور جامع بر روشهای مسیریابی و زنجیره آبشاری نیز نتیجه میگیرد که ساخت و ارزیابی سازوکارهایی که در معماریها و کاربردهای گوناگون تعمیم پیدا کنند، هنوز چالشی حلنشده است[۴]. به نظر میرسد وجه مشترک همه این شواهد این باشد که عدد صرفهجویی جدا از مجموعه ارزیابیای که با آن سنجیده شده معنایی ندارد.
اعداد فروشندگان را چگونه باید خواند
آمازون در آزمونهای داخلی خود، صرفهجویی هزینه را در مقایسه با بزرگترین مدل هر خانواده برای Nova برابر ۳۵ درصد، برای Anthropic برابر ۵۶ درصد و برای Meta برابر ۱۶ درصد گزارش کرده است[۶]. در آزمون داخلی دیگری روی مجموعهای از پرامپتها، به ادعای آمازون، ۶۰ درصد صرفهجویی با کیفیتی همسطح Claude Sonnet 3.5 v2 به دست آمده است[۶]. خود آمازون تأکید میکند که این نتایج فقط برای مقایسه با مسیریابی تصادفی در داخل هر خانواده معتبر است[۶]. تعریف صرفهجویی هم در این آزمونها بیشترین هزینه صرفهجوییشده نسبت به قویترین مدل برای رسیدن به سطح مشخصی از کیفیت است[۶]. کیفیت نیز با شاخص ARQGC و در مقایسه با یک مدل پاداش (reward model) اندازهگیری شده است[۶].
مستندات همین سرویس محدودیتها را صریح بیان میکند. مسیریابی فقط برای پرامپتهای انگلیسی بهینه شده، نمیتواند تصمیمهایش را با داده عملکرد اختصاصی هر برنامه تنظیم کند و ممکن است برای کاربردهای تخصصی بهترین انتخاب را نکند[۵]. طبق همین مستندات، کارایی مسیریابی به داده آموزشی اولیه وابسته است[۵]. آمازون از مشتریان میخواهد روتر را روی وظیفه و دامنه تخصصی خودشان بیازمایند، چون نتایج از موردی به مورد دیگر فرق میکند[۶].
روتر مایکروسافت در حالت پیشفرض Balanced، مدلهایی را بررسی میکند که کیفیتشان برای آن پرامپت در بازه کوچکی، مثلاً ۱ تا ۲ درصد، با بهترین مدل فاصله دارد و از میان آنها ارزانترین را انتخاب میکند[۸]. در حالت Cost این بازه به حدود ۵ تا ۶ درصد بزرگ میشود[۸]. مایکروسافت هم تأکید میکند که ارزیابی همچنان لازم است و روتر باید با خط پایه فعلی مقایسه شود[۸]. اگر بهروزرسانی خودکار فعال باشد، مجموعه مدلهای زیربنایی تغییر میکند و این تغییر میتواند روی عملکرد و هزینه اثر بگذارد[۸].
افت کیفیت پنهان کجا شکل میگیرد
برداشت ما این است که عبارت بدون افت کیفیت در این ادعاها نادرست نیست، اما دامنه محدودی دارد. کیفیت بهطور میانگین و با معیاری سنجیده شده که سازنده روتر انتخاب کرده است. میانگین میتواند خوب بماند در حالی که افت در یک دسته خاص از درخواستها جمع شده باشد، مثلاً پرسشهای حقوقی، محاسبات مالی یا پرسشهایی که به زبانی غیر از انگلیسی نوشته شدهاند. بازه بزرگتر حالت Cost هم یک انتخاب طراحی است که افت کیفیت را آگاهانه میپذیرد. پذیرفتن چنین افتی در پاسخگویی عمومی به مشتری معنایی دارد و در وظایف پرریسک معنایی کاملاً متفاوت.
این نتیجه به آن معنا نیست که الگوریتم اهمیتی ندارد. تفاوت امتیاز روترها در آزمونهای فروشندگان نشان میدهد که کیفیت خود روترها هم یکسان نیست. اما به نظر میرسد تا وقتی سازمان نمیداند مدل ارزان در کدام وظایف شکست میخورد، راهی هم برای تشخیص روتر خوب از روتر بد ندارد. در نتیجه تعیینکننده اصلی صرفهجویی واقعی، داده ارزیابی است.
یک اثر مرتبه دوم محتمل این است که مجموعه ارزیابی در سطح وظیفه به دارایی راهبردی تبدیل شود. سازمانی که چنین مجموعهای دارد، میتواند روترهای رقیب را مقایسه کند و با تغییر مدلهای زیربنایی، اثر آن را بسنجد. سازمانی که ندارد، ناچار است تعریف فروشنده از کیفیت را بپذیرد.
پیش از روشنکردن روتر چه باید ساخت
اولین اهرم، انتخاب آگاهانه مدل پشتیبان است. آمازون توضیح میدهد که اگر آستانه تفاوت کیفیت ۱۰ درصد باشد و Claude 3 Sonnet مدل پشتیبان، روتر افتی ۱۰ درصدی نسبت به Sonnet را هدف میگیرد[۶]. اگر Claude 3 Haiku مدل پشتیبان باشد، هدف روتر بهبودی بیش از ۱۰ درصد نسبت به Haiku خواهد بود[۶]. آمازون همچنین پیشنهاد میکند آستانههای مختلف روی مجموعهداده توسعه آزموده شوند[۶]. برداشت ما این است که همین تنظیم، تعریف کیفیت را تعیین میکند و تصمیمی مدیریتی است، نه صرفاً فنی.
اهرم دوم، ثبت منظم دادههاست. پاسخ Bedrock مشخص میکند کدام مدل درخواست را پردازش کرده است[۵]. تیم داده میتواند با این اطلاعات کیفیت را به تفکیک مدل و نوع وظیفه تحلیل کند و افتهایی را پیدا کند که در میانگین دیده نمیشوند. محدودیتهای فنی را هم نباید از نظر دور داشت: در روتر مایکروسافت، پنجره زمینه مؤثر به کوچکترین مدل زیربنایی محدود است[۸]. سربار روتر آمازون هم حدود ۸۵ میلیثانیه در صدک ۹۰ است[۶].
برای تیمهای محصول و بازاریابی، پیشنهاد عملی این است که پیش از فعالکردن روتر، برای هر وظیفه اصلی مجموعهای کوچک از نمونههای برچسبخورده و یک معیار پذیرش روشن تعریف کنند. روتر هم بهتر است مدتی در حالت سایه، یعنی موازی با مدل فعلی و بدون تحویل پاسخ به کاربر، با خط پایه مقایسه شود. آمازون گزارش کرده که با بهتر شدن مدل ارزانتر هر خانواده، سهم بیشتری از درخواستها به آن فرستاده میشود[۶]. به نظر میرسد این یعنی ارزیابی باید با هر نسل تازه مدلها تکرار شود.
| خانواده مدل | میانگین ARQGC | صرفهجویی هزینه | بهبود تأخیر |
|---|---|---|---|
| Nova | ۰٫۷۵ | ۳۵ درصد | ۹٫۹۸ درصد |
| Anthropic | ۰٫۸۶ | ۵۶ درصد | ۶٫۱۵ درصد |
| Meta | ۰٫۷۸ | ۱۶ درصد | ۹٫۳۸ درصد |
خط زمانی
- 2024-06-26: انتشار نسخه نخست مقاله RouteLLM درباره روترهای آموزشدیده با داده ترجیحات انسانی[۱]
- 2025-02-23: انتشار نسخه چهارم مقاله RouteLLM[۱]
- 2025-04-22: عرضه عمومی Intelligent Prompt Routing در Amazon Bedrock با امکان انتخاب هر دو مدل از یک خانواده[۷]
- 2025-05-19: نسخهای از روتر مایکروسافت که اکنون ثابت شده و مدل تازهای به آن اضافه نمیشود[۸]
- 2025-11-18: نسخه فعال روتر مایکروسافت که مدلهای تازه بدون تغییر شناسه نسخه به آن اضافه میشوند[۸]
برای کسبوکارهای ایرانی
مستندات Bedrock میگوید مسیریابی آن فقط برای پرامپتهای انگلیسی بهینه شده است[۵]. به نظر میرسد برای محصولاتی که با پرسشهای فارسی کار میکنند، تکیه بر روتر آماده بدون یک مجموعه ارزیابی فارسی در سطح هر وظیفه، خطر افت کیفیت پنهان را بیشتر میکند. رویکرد RouteLLM، یعنی آموزش روتر با داده ترجیحات[۱]، نشان میدهد که ساخت روتر داخلی بر پایه داده ارزیابی خود تیم امکانپذیر است. این رویکرد میتواند برای تیمهایی که به سرویسهای مدیریتشده دسترسی محدودی دارند گزینهای عملی باشد، هرچند به مهارت ارزیابی و برچسبگذاری نیاز دارد.
چه چیزی را باید دنبال کرد
- آیا روترهای مدیریتشده امکان تنظیم تصمیمها با داده عملکرد اختصاصی هر برنامه را اضافه میکنند؛ محدودیتی که مستندات فعلی Bedrock آن را صریحاً ذکر کرده است.
- اثر بهروزرسانی خودکار مدلهای زیربنایی در روتر مایکروسافت بر کیفیت و هزینه، بهویژه برای سازمانهایی که خط پایه ثابتی ندارند.
- پیشرفت بنچمارکهای مستقلی مثل RouterBench در سنجش تعمیمپذیری روترها به دامنهها و زبانهای غیر از انگلیسی.
منابع
- RouteLLM: Learning to Route LLMs with Preference Data — arXiv.org، انتشار: 2024-06-26، مرجع پایه، دسترسی: 2026-09-19
- FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance — arXiv.org، منبع مرجع، دسترسی: 2026-09-19
- RouterBench: A Benchmark for Multi-LLM Routing System — arXiv.org، منبع مرجع، دسترسی: 2026-09-19
- Dynamic Model Routing and Cascading for Efficient LLM Inference: A Survey — arXiv.org، منبع مرجع، دسترسی: 2026-09-19
- Understanding intelligent prompt routing in Amazon Bedrock — docs.aws.amazon.com، منبع مرجع، دسترسی: 2026-09-19
- Use Amazon Bedrock Intelligent Prompt Routing for cost and latency benefits | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-09-19
- Amazon Bedrock Intelligent Prompt Routing is now generally available - AWS — Amazon Web Services, Inc.، انتشار: 2025-04-22، شواهد تازه، دسترسی: 2026-09-19
- Model router for Microsoft Foundry concepts - Microsoft Foundry — MicrosoftLearn، منبع مرجع، دسترسی: 2026-09-19
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-19.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر