قفل تازه لیکهاوس، فایل نیست؛ کاتالوگ است
با فراگیر شدن قالبهای باز جدولی، نقطه کنترل لیکهاوس از فایل به کاتالوگ منتقل شده است؛ تحلیلی درباره هزینه خروج، فدراسیون کاتالوگ و مرز تضمینها.
فهرست مطالب
آپاچی آیسبرگ به یک بلوک بنیادی معماریهای لیکهاوس مستقل از فناوری تبدیل شده و همه سکوهای بزرگ داده، از Athena و EMR و Redshift در AWS تا Snowflake و Databricks و Google BigQuery، از آن پشتیبانی میکنند[۶]. پس پرسش امروز یک تیم داده این نیست که جدولها در چه فرمتی بنشینند؛ پرسش این است که چرا با وجود قالب باز، عبور دادن یک بار کاری از موتوری به موتور دیگر هنوز گران و پرریسک است. پاسخ را باید یک لایه بالاتر از فایل جستوجو کرد: در کاتالوگ؛ جایی که متادیتا ثبت میشود، مجوزها اعمال میشود و اصلاً تعیین میشود که یک جدول برای یک مصرفکننده وجود دارد یا ندارد. ادعای این تحلیل ساده است: انتخاب قالب جدول عملاً حل شده و آنچه برای سالها هزینه خروج، امکان چندموتوری بودن و قدرت چانهزنی با فروشنده را تعیین میکند، انتخاب کاتالوگ و شناخت مرز تضمینهایی است که آن کاتالوگ نمیدهد.
واقعیتهای کلیدی
- AWS در نوامبر ۲۰۲۵ عرضه عمومی فدراسیون کاتالوگ را اعلام کرد: پرسوجوی جدولهای آیسبرگ در کاتالوگهای ریموت بدون جابهجایی یا کپی داده، با همگامسازی بیدرنگ متادیتا.[۱]
- کنترل دسترسی این جدولهای ریموت از طریق Lake Formation انجام میشود، با مجوز ریزدانه، اشتراک بینحسابی و انتشار هویت مورد اعتماد؛ شرط اتصال، پیروی کاتالوگ مقابل از مشخصات Iceberg REST است.[۱]
- Apache Polaris در فوریه ۲۰۲۶ به پروژه سطح بالای بنیاد آپاچی ارتقا یافت؛ به گفته پروژه، یک پیادهسازی مستقل از فروشنده از Iceberg REST Catalog است.[۳]
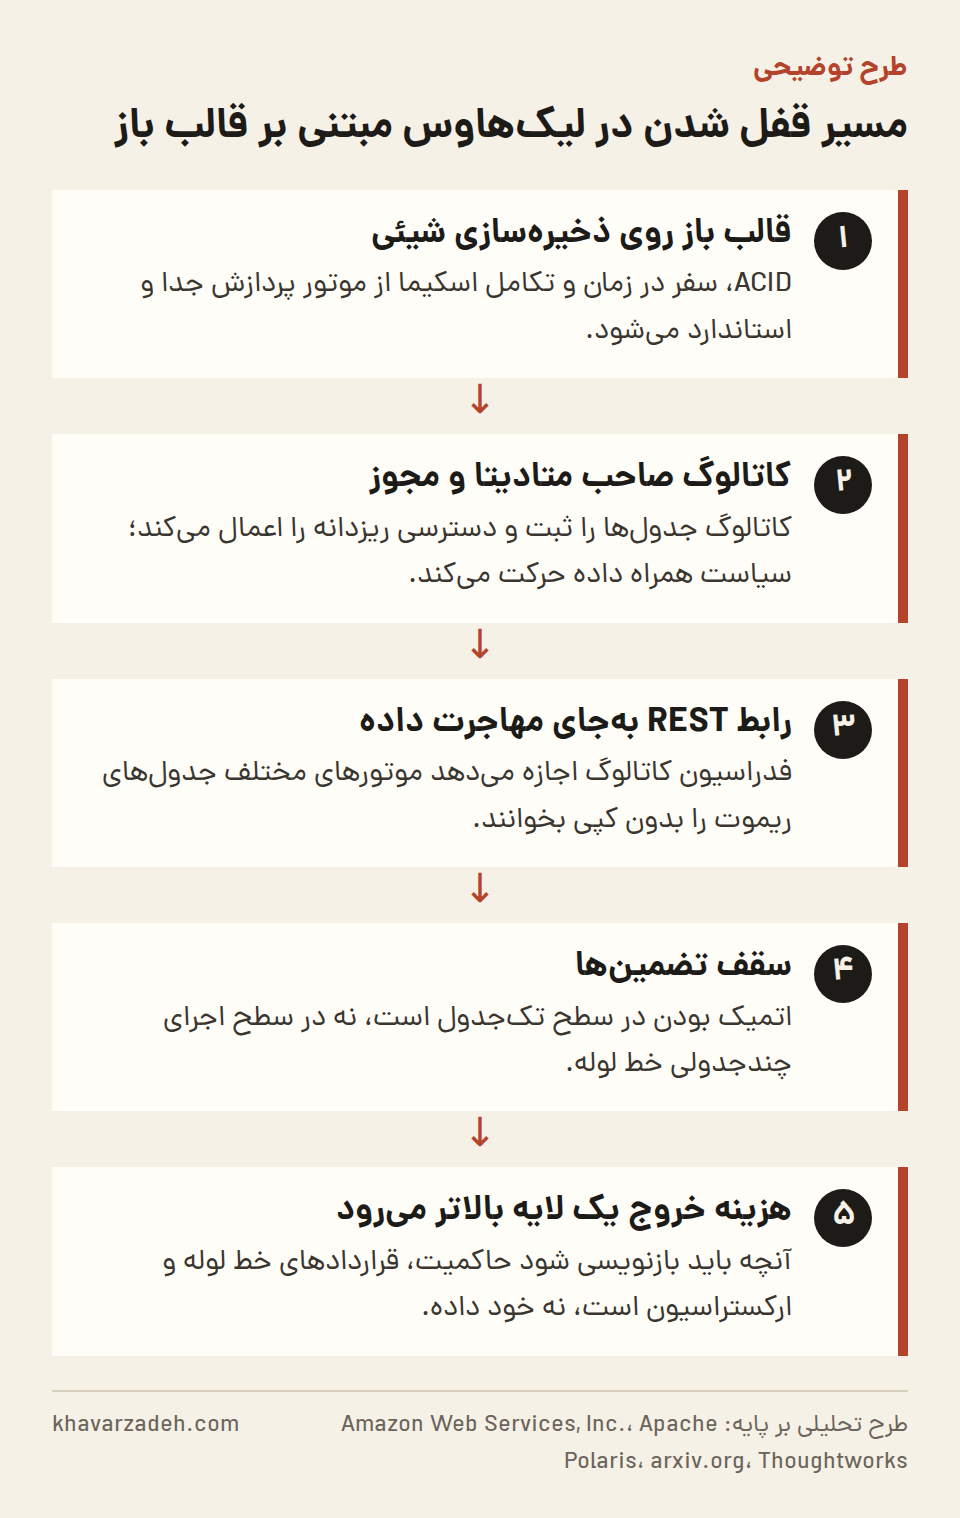
- به روایت مقالهای پژوهشی در ژانویه ۲۰۲۶، قالبهای باز فقط اتمیک بودن سطح جدول را تضمین میکنند و لیکهاوسهای پیشرو صنعت API آمادهای برای تراکنش خط لوله ارائه نمیکردند.[۴]
- در مدل قیمتگذاری Glue Data Catalog، بابت ذخیره و دسترسی به متادیتا هزینه ماهانه پرداخت میشود؛ ۱ میلیون شیء و ۱ میلیون دسترسی نخست رایگان است.[۲]
- Thoughtworks آیسبرگ را بلوک بنیادی معماریهای مستقل از فناوری و انتخاب پیشفرض سکوهای داده مدرن معرفی میکند.[۶]
وقتی محاسبه از ذخیرهسازی جدا شد، متادیتا جا ماند
در انبارهای داده کلاسیک، ذخیرهسازی، متادیتا و محاسبه هر سه در یک لایه بودند؛ با آمدن چارچوبهای توزیعشده مانند Hadoop، Hive، Spark و Presto این اجزا از هم جدا شدند و ایده این بود که موتور پردازش از ذخیرهسازی جدا بماند اما متادیتا نزدیک به ذخیرهسازی نگه داشته شود تا موتورهای مختلف بتوانند آن را بخوانند و نسخه تازهای از آن بسازند[۵]. قالبهای جدولی مدرن مانند Delta Lake، Hudi و Iceberg دقیقاً برای همین شکاف ساخته شدند: خواندن و نوشتن همروند، سفر در زمان، اصلاح و ادغام داده دیررس، و تکامل و اعمال اسکیما[۵]. Iceberg در اصل از نتفلیک آمد و در ۲۰۱۸ بهصورت متنباز و بهعنوان پروژه انکوباتور آپاچی منتشر شد[۵].
این پایه فنی اکنون به اندازه کافی پخته است. Thoughtworks طراحی مبتنی بر اسنپشات آیسبرگ را عامل ایزولاسیون سریالپذیر، نوشتن همروند امن با همروندی خوشبینانه و تاریخچه نسخه با امکان بازگشت میداند و آن را انتخاب پیشفرض سازمانهایی معرفی میکند که سکوی داده مدرن میسازند[۶]. در سطح راهبرد هم Forrester لیکهاوس را ترکیب انبار داده و دریاچه داده توصیف میکند که تحلیل بیدرنگ را پشتیبانی میکند، هزینه سکو را پایین میآورد و حاکمیت داده را بهبود میدهد[۷]. هر دو منبع مرجعاند و نه گزارش تازه؛ اهمیتشان در این است که نشان میدهند بحث قالب باز دیگر یک بحث نوظهور نیست.
کاتالوگ چگونه به نقطه کنترل تبدیل شد
شواهد تازهتر همین جابهجایی را نشان میدهد. AWS در نوامبر ۲۰۲۵ عرضه عمومی فدراسیون کاتالوگ برای کاتالوگهای ریموت آیسبرگ را اعلام کرد: امکان پرسوجوی جدولهای آیسبرگ ثبتشده در کاتالوگهای دیگر، بدون جابهجایی یا کپی جدول، با همگامسازی بیدرنگ متادیتا میان Glue Data Catalog و کاتالوگ ریموت[۱]. فهرست موتورهای پشتیبانیشده شامل Redshift، EMR، Athena، Glue، موتورهای ثالث مانند Apache Spark و SageMaker است، و شرط اتصال این است که کاتالوگ مقابل از مشخصات Iceberg REST پیروی کند[۱]. نکته تعیینکننده جای دیگری است: کنترل دسترسی این جدولها از طریق Lake Formation انجام میشود، با مجوزهای ریزدانه، اشتراکگذاری بینحسابی و انتشار هویت مورد اعتماد[۱].
در سمت متنباز، Apache Polaris در فوریه ۲۰۲۶ از انکوباتور آپاچی فارغالتحصیل شد و به پروژه سطح بالا رسید[۳]. به گفته این پروژه، Polaris یک پیادهسازی مستقل از فروشنده از مشخصات Iceberg REST Catalog است و با تضمین اینکه Dremio، Snowflake، Spark، Trino و Flink همگی به یک منبع حقیقت واحد نگاه میکنند، یکی از بزرگترین دردسرهای معماری داده یعنی وابستگی به فروشنده را هدف گرفته است[۳]. قابلیتهایی که پروژه برای خود برمیشمارد نیز دقیقاً همانهایی است که قبلاً دارایی انحصاری انبار داده بود: همکارکردی میان موتورها، کنترل دسترسی ریزدانه و پشتیبانی چندابری[۳].
اقتصاد این لایه هم دیگر پنهان نیست. در مدل قیمتگذاری Glue Data Catalog، بابت ذخیره و دسترسی به متادیتا هزینه ماهانه پرداخت میشود و ۱ میلیون شیء نخست و ۱ میلیون دسترسی نخست رایگان است[۲]. در همان منبع، AWS اعلام کرده Glue 6.0 با قیمتی ۳۰ درصد پایینتر از نسخههای پیشین و با پیادهسازی کامل مشخصات Iceberg v3 روی زمان اجرای Spark 4.1 عرضه شده است[۲]. وقتی متادیتا هم واحد اندازهگیری و هم واحد صورتحساب میشود، یعنی مالکیت کاتالوگ صرفاً یک تصمیم فنی نیست.
سقف تضمینها: جدول اتمیک است، خط لوله نه
پژوهشی که در ژانویه ۲۰۲۶ منتشر شد، همان نقطهای را میشکافد که فروشندگان کمتر دربارهاش حرف میزنند. به روایت این مقاله، لیکهاوس به بستر پیشفرض تحلیل و هوش مصنوعی تبدیل شده اما زیر تغییرات همزمان و غیرقابلاعتماد شکننده است: ناسازگاری اسکیما اغلب فقط در زمان اجرا بروز میکند، محیط توسعه و تولید بهراحتی از هم فاصله میگیرند و خط لولههای چندجدولی پس از شکست میتوانند نتیجه ناقص منتشر کنند[۴].
ریشه مشترک این خطاها معنایی است: قالب باز، اتمیک بودن را در سطح تکجدول تضمین میکند، در حالی که خط لوله ذاتاً چندجدولی و اغلب چندزبانه است و بدون مفهوم تراکنش خط لوله، مصرفکننده پاییندست ترکیبی از جدولهای قدیمی و جدید را میبیند[۴]. نویسندگان مینویسند که در زمان نگارش مقاله، لیکهاوسهای پیشرو صنعت یعنی Snowflake و Databricks هیچ API آمادهای برای تراکنش خط لوله ارائه نمیکردند[۴]. همان مقاله راهحلهای وصلهای را هم رد میکند؛ از جمله ساخت کاتالوگ کسبوکاری که به گفته پژوهش، تلاش زیادی برای ساخت و نگهداری میطلبد[۴].
تصمیمی که معمولاً بدون حضور مدیر گرفته میشود
برداشت ما این است که گزاره رایجِ قالب باز یعنی پایان وابستگی به فروشنده، واقعیت را بزرگتر از آنچه هست نشان میدهد. قابل حمل بودن فایلها شرط لازم است، نه کافی. آنچه واقعاً جابهجا نمیشود، سیاستهای دسترسی، تاریخچه مجوزها، قراردادهای میان گرههای خط لوله و رفتار تراکنشی سکو است؛ و اینها همگی بالای قالب جدول زندگی میکنند. به همین دلیل هزینه مهاجرت میان موتورها معمولاً از جنس بازنویسی حاکمیت و ارکستراسیون است، نه از جنس انتقال داده.
اگر مشخصات REST به رابط عملی میان کاتالوگها تبدیل شود، میتوان انتظار داشت رقابت فروشندگان از نگهداشتن داده به نگهداشتن کنترل دسترسی و لایه معنایی منتقل شود. یک اثر مرتبه دوم محتمل این است که مذاکره تخفیف بر سر محاسبه آسانتر و بر سر حاکمیت و متادیتا سختتر شود؛ یعنی دقیقاً جایی که خریدار کمترین ابزار مقایسه را دارد. این یک تفسیر است، نه یافته منابع.
برای تیمهای داده و محصول، سه پرسش عملی باقی میماند. نخست، کاتالوگ در اختیار کیست و آیا سیاستهای دسترسی آن قابل استخراج و بازسازی در جای دیگر است. دوم، آیا تعریفهای تجاری و قراردادهای میان مراحل خط لوله در کد و نسخهبندیشده نگهداری میشوند یا در پیکربندی یک سکو حبساند. سوم، در سناریوی خروج، چه چیزی واقعاً باید بازنویسی شود و برآورد نفر-ماه آن چقدر است. به نظر میرسد سازمانهایی که این سه پاسخ را مکتوب دارند، عملاً همانهاییاند که میتوانند چندموتوری بودن را ادعا کنند.
برنده این جابهجایی احتمالاً موتورهای تخصصی و کوچکاند که دیگر لازم نیست کل انبار را جایگزین کنند تا وارد شوند؛ بازنده احتمالی، مدل کسبوکاری است که حاشیه سود خود را از قفل شدن داده در فرمت اختصاصی میگرفت. اما این گذار خودکار نیست: اگر تیم داده کاتالوگ را صرفاً یک جزئیات پیادهسازی ببیند، همان وابستگی قبلی با نامی تازه بازتولید میشود.
| لایه | آنچه استاندارد باز پوشش میدهد | آنچه وابسته به پیادهسازی میماند |
|---|---|---|
| فایل و قالب جدول | ایزولاسیون سریالپذیر، همروندی خوشبینانه، تاریخچه نسخه و بازگشت | بهینهسازیهای بومی هر موتور پردازشی |
| کاتالوگ | مشخصات Iceberg REST بهعنوان رابط مشترک میان موتورها | پیادهسازی کاتالوگ، همگامسازی متادیتا و مدل سرویس |
| کنترل دسترسی | سیاست متمرکزی که همراه داده حرکت میکند | اعمال ریزدانه، اشتراک بینحسابی و انتشار هویت در سرویس ابری |
| تراکنش | اتمیک بودن در سطح تکجدول | اتمیک بودن کل اجرای چندجدولی خط لوله |
| بازبینی و بازتولید | — | نسخهبندی شبیه Git و قراردادهای نوعدار میان گرههای خط لوله |
خط زمانی
- 2025-11-24: AWS عرضه عمومی فدراسیون کاتالوگ Glue برای کاتالوگهای ریموت آپاچی آیسبرگ را اعلام کرد.[۱]
- 2026-01-30: انتشار مقاله پژوهشی درباره طراحی لیکهاوس درستبنیاد و کمبود تراکنش در سطح خط لوله.[۴]
- 2026-02-19: Apache Polaris از انکوباتور فارغالتحصیل شد و به پروژه سطح بالای بنیاد نرمافزار آپاچی رسید.[۳]
برای کسبوکارهای ایرانی
برای تیمهای داده در ایران، نکته عملی این است که پشته لیکهاوس امروز در سطح مشخصات باز قابل بازسازی است: قالب جدولی باز روی ذخیرهسازی شیئی سازگار با S3، بهعلاوه یک کاتالوگ متنباز که از مشخصات Iceberg REST پیروی میکند و دسترسی ریزدانه و چندابری را پوشش میدهد[۳][۶]. به نظر میرسد ارزش این مسیر بیش از صرفهجویی، در استقلال معماری باشد: وقتی کاتالوگ در اختیار خود سازمان است، تعویض موتور پردازشی یک تصمیم مهندسی میماند و به مذاکره با یک تأمینکننده گره نمیخورد. در مقابل، همان محدودیتی که پژوهشها به آن اشاره کردهاند اینجا هم برقرار است: تضمین اتمیک بودن در سطح جدول، مسئولیت درستی خط لوله چندجدولی را از تیم برنمیدارد[۴]. سرمایهگذاری روی مهارت مدلسازی، قرارداد داده و بازبینی تغییرات، در این معماری بازده بیشتری دارد تا انتخاب برند سکو.
چه چیزی را باید دنبال کرد
- اینکه چند کاتالوگ تجاری و متنباز عملاً به مشخصات Iceberg REST پایبند بمانند و فدراسیون میان آنها بدون کپی داده کار کند.
- اینکه آیا سکوهای بزرگ به سمت ارائه API تراکنش در سطح خط لوله حرکت میکنند یا این لایه در اختیار ابزارهای مستقل میماند.
- تغییر ساختار قیمتگذاری متادیتا و کاتالوگ در برابر قیمت محاسبه، بهعنوان نشانهای از اینکه حاشیه سود فروشندگان به کدام لایه منتقل میشود.
- مسیر جامعه Apache Polaris پس از ارتقا به پروژه سطح بالا: پشتیبانی از موتورها و پسزمینههای ذخیرهسازی بیشتر.
منابع
- AWS Glue announces catalog federation for remote Apache Iceberg catalogs - AWS — Amazon Web Services, Inc.، انتشار: 2025-11-24، شواهد تازه، دسترسی: 2026-09-17
- AWS Glue 6.0 now available with 30% lower price and full Apache Iceberg v3 support | Amazon Web Services — Amazon Web Services، منبع مرجع، دسترسی: 2026-09-17
- Apache Polaris Graduates to Top Level Project! — Apache Polaris، انتشار: 2026-02-19، شواهد تازه، دسترسی: 2026-09-17
- Building a Correct-by-Design Lakehouse — arxiv.org، انتشار: 2026-01-30، شواهد تازه، دسترسی: 2026-09-17
- Data lake table formats — Thoughtworks، منبع مرجع، دسترسی: 2026-09-17
- Apache Iceberg | Technology Radar | Thoughtworks Spain — Thoughtworks، منبع مرجع، دسترسی: 2026-09-17
- Data Lakehouse Is The New Data Warehouse And Data Lake | Forrester — forrester.com، منبع مرجع، دسترسی: 2026-09-17
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-18.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر