ارزانشدن توکن، گرانشدن صورتحساب: چرا واحد درست اقتصاد هوش مصنوعی هزینه هر کار است
قیمت توکن برای توانایی ثابت سالانه ۹ تا ۹۰۰ برابر افت کرده، اما مدلهای استدلالی و عاملها توکن بیشتری برای هر کار مصرف میکنند؛ واحد درست هزینه هر کار است.
فهرست مطالب
اگر قیمت مدلها مدام پایین میآید، چرا صورتحساب هوش مصنوعی سازمان پایین نمیآید؟ پاسخ کوتاه این است که معمولاً منحنیهای متفاوتی با هم اشتباه گرفته میشوند. دادههای Epoch AI نشان میدهد قیمت رسیدن به سطح ثابتی از عملکرد، بسته به وظیفه، بین ۹ تا ۹۰۰ برابر در سال کاهش یافته است[۱]. اما به گفته همین مؤسسه، مدلهایی که با یادگیری تقویتی تقویت شدهاند کارهای دشوارتر را عمدتاً با خروجیهای طولانیتر انجام میدهند؛ یعنی زنجیره استدلال، فراخوانی ابزار و نوشتن بیشتر[۲]. صورتحساب سازمان در عمل حاصلضرب قیمت هر توکن در تعداد توکنهایی است که هر کار مصرف میکند، و مدلهای استدلالی و عاملها دقیقاً ضریب دوم را بزرگ میکنند. یک قید مهم: منابعی که در اختیار داریم افزایش هزینه کل سازمانها را اندازه نگرفتهاند؛ آنچه نشان میدهند سازوکاری است که چنین افزایشی را ممکن و محتمل میکند. برداشت ما این است که واحد درست اقتصاد هوش مصنوعی، هزینه هر کار انجامشده است، نه قیمت فهرست هر میلیون توکن.
واقعیتهای کلیدی
- قیمت رسیدن به سطح ثابتی از عملکرد مدلهای زبانی، بسته به وظیفه، بین ۹ تا ۹۰۰ برابر در سال کاهش یافته است.[۱][۳]
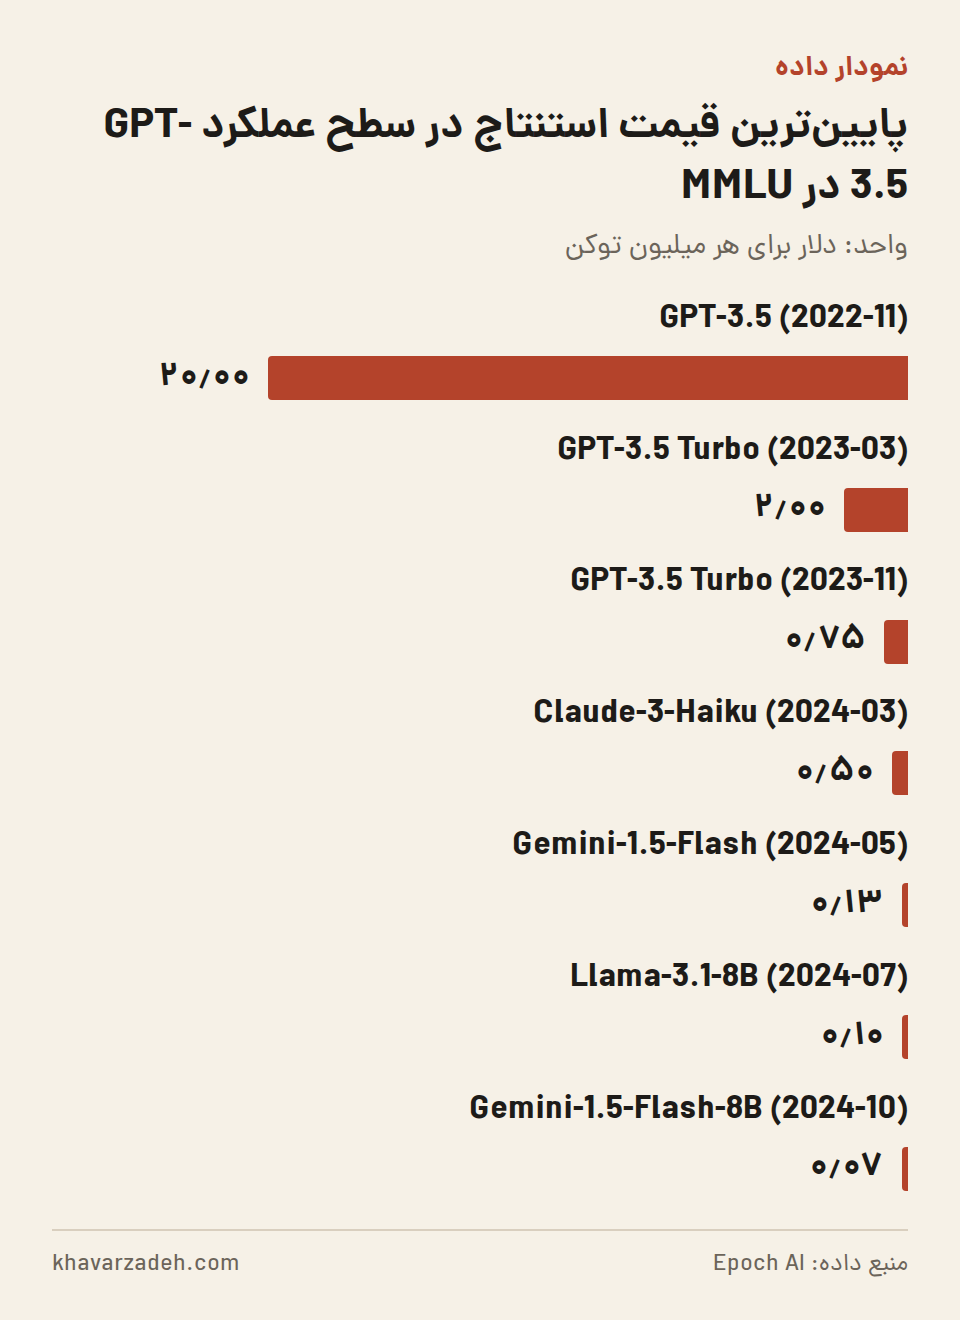
- هزینه مدلی همسطح GPT-3.5 در MMLU از ۲۰ دلار برای هر میلیون توکن در نوامبر ۲۰۲۲ به ۰٫۰۷ دلار در اکتبر ۲۰۲۴ رسید.[۱][۳]
- Epoch AI روند کلی را حدود ۵ تا ۱۰ برابر کاهش هزینه در سال برای رسیدن به سطح توانایی معین برآورد میکند و درباره تداوم آن احتیاط میکند.[۲]
- در FrontierMath، رسیدن به حدود ۲۷ درصد دقت از حدود ۴۳ میلیون توکن خروجی در آوریل ۲۰۲۵ به حدود ۵ میلیون توکن در دسامبر ۲۰۲۵ رسید.[۲]
- در API شرکت Anthropic توکنهای تفکر جزو توکنهای خروجی صورتحسابشدهاند و حداقل بودجه تفکر ۱٬۰۲۴ توکن است.[۶]
- به گفته EY، بیشتر طرحهای عاملمحور هزینه را کمتر از واقع برآورد میکنند، چون قیمت مدل را جدا از هزینه کل مالکیت میبینند.[۴]
افت قیمت برای توانایی ثابت، و آنچه این عدد نمیگوید
پژوهش Epoch AI عملکرد مدلهای پیشرو را روی ۶ بنچمارک در بازهای ۳ ساله بررسی کرده و سنجیده است که قیمت رسیدن به هر سطح عملکرد با چه سرعتی پایین آمده است[۱]. برای نمونه، قیمت رسیدن به عملکرد GPT-4 در مجموعهای از سؤالات علمی سطح دکتری سالانه ۴۰ برابر کاهش یافته است[۱]. گزارش AI Index دانشگاه استنفورد هم افت هزینه پرسوجو برای یک سطح ثابت عملکرد در بنچمارک MMLU را کاهشی بیش از ۲۸۰ برابری در حدود ۱۸ ماه توصیف میکند[۳].
عوامل پشت این افت هم مشخصاند. به گزارش استنفورد، هزینه سختافزار یادگیری ماشین به ازای عملکرد سالانه ۳۰ درصد کم شده و بهرهوری انرژی سالانه ۴۰ درصد بالا رفته است[۳]. Epoch AI در تحلیلی جداگانه روند کلی را تقریباً ۵ تا ۱۰ برابر کاهش هزینه در سال برای رسیدن به سطح توانایی معین برآورد میکند و آن را به مدلهای کوچکتری که از راه تقطیر ساخته میشوند، بهبودهای الگوریتمی استنتاج و نسلهای تازه GPU نسبت میدهد[۲].
همین منابع هشدارهای مهمی هم دارند. Epoch AI میگوید سریعترین افتها در سال آخر بازه رخ داده و روشن نیست ادامه یابد[۱]. این مؤسسه همچنین احتمال میدهد بخشی از افت سریع هزینه ناشی از سنجش توانایی با بنچمارکها باشد، جایی که مدلهای تقطیرشده عملکرد نامتناسبی خوب دارند، و این مدلها را در مجموع شکنندهتر میداند[۲]. نکته کلیدی برای مدیر مالی این است که همه این اعداد درباره قیمت یک سطح ثابت تواناییاند، نه درباره کاری که تیمها امروز واقعاً از مدل میخواهند؛ سازمانها معمولاً همان سطح دیروز را نمیخرند، بلکه سراغ مدل و کار دشوارتر میروند.
توکنهای تفکر و حلقههای عامل؛ ضریبی که در قیمت فهرست دیده نمیشود
Epoch AI در پاسخ به تحلیل توبی اورد تأکید میکند که هزینه استنتاج برخلاف هزینه آموزش، هزینهای متغیر به ازای هر استفاده است و با خدمتدادن به کاربران بیشتر سرشکن نمیشود[۲]. مثال FrontierMath اندازه این ضریب را نشان میدهد: رسیدن به حدود ۲۷ درصد دقت در آوریل ۲۰۲۵ با o4-mini در سطح استدلال بالا حدود ۴۳ میلیون توکن خروجی لازم داشت و در دسامبر ۲۰۲۵ با GPT-5.2 در سطح استدلال پایین حدود ۵ میلیون توکن[۲]. Epoch AI با احتساب تفاوت قیمت هر توکن خروجی، این را حدود ۳ برابر کاهش هزینه در ۸ ماه میداند[۲]. از مقایسه این اعداد میتوان برداشت کرد که در این مثال صرفهجویی بیشتر از کمشدن تعداد توکنها آمده است تا از ارزانترشدن هر توکن.
مستندات Anthropic نشان میدهد این ضریب چگونه به پارامتری فنی تبدیل میشود. در حالت دستی تفکر گسترده، توسعهدهنده برای هر درخواست بودجه تفکر تعیین میکند که حداقل آن ۱٬۰۲۴ توکن است، و توکنهای تفکر بخشی از توکنهای خروجی صورتحسابشدهاند[۶]. همین مستندات برای کارهای پیچیده شروع با بودجه ۱۶٬۰۰۰ توکن یا بیشتر را پیشنهاد میکند، بودجه را هدف و نه سقف قطعی میداند و یادآوری میکند که تغییر بودجه میان درخواستها کش پرامپت را باطل میکند[۶]. به نظر میرسد تصمیمی که یک مهندس در کد میگیرد، مستقیماً به خط هزینه مالی تبدیل میشود.
در عاملها ضریب بزرگتر است. Thoughtworks عاملی را توصیف میکند که ۵۰ فایل زمینه را میخواند، آزمون را اجرا میکند، شکست میخورد و دوباره از نو شروع میکند، و به گفته این شرکت هر تکرار میتواند حجم بسیار بزرگی از توکن مصرف کند[۵]. در مثال دیگری از همین منبع، بازبینی خودکار کد برای ۱۰ توسعهدهنده با ۳ درخواست ادغام در روز تا پایان ماه میتواند به میلیونها توکن برسد[۵]. به ادعای Thoughtworks، در مدل پرداخت به ازای مصرف، یک کار بازآرایی کد میتواند از هزینه سرور میزبان برنامه بیشتر شود[۵].
از قیمت توکن به هزینه هر کار: توصیههایی که منابع پشتیبانی میکنند
به گفته EY، بیشتر طرحهای هوش مصنوعی عاملمحور هزینه را کمتر از واقع برآورد میکنند، چون قیمت مدل را جدا از کل پوسته عملیاتی میبینند[۴]. EY پیشنهاد میکند هزینه زیرساخت، هماهنگسازی، پایش و نیروی انسانی در حلقه از ابتدا در طرح توجیهی دیده شود و عملیات فعلی بر مبنای هر کار یا هر نتیجه سنجیده شود[۴]. به گفته همین منبع، امروز پاسخدادن به اینکه یک واحد کار عامل چقدر مصرف میکند تقریباً ناممکن است[۴]. توصیه عملی دیگر EY نصب قطعکنندههای مدار پیش از مقیاسدادن است: سقف هزینه، سقف تعداد فراخوانی و خاموشی خودکار در سطح عامل، گردشکار و واحد کسبوکار، همراه با یک مسئول واحد برای اقتصاد عاملها[۴].
Thoughtworks از زاویه دیگری هشدار میدهد: وابستگی فرایندها به عاملها میتواند چنان عمیق شود که خاموشکردن سرویس به معنای توقف عملیات باشد[۵]. پیشنهاد این شرکت استفاده از مدلهای متنباز، مدلهای کوچکتر روی زیرساخت خود سازمان و لایههای انتزاعی است که تعویض ارائهدهنده مدل را آسان میکند[۵].
اشتراک ثابت در برابر مصرف متغیر: چه کسی زیان میبیند
محصولی که با اشتراک ماهانه ثابت فروخته میشود و پشت آن عاملهایی با مصرف متغیر کار میکنند، ریسک مصرف را از مشتری به فروشنده منتقل میکند. در چنین مدلی، سنگینترین کاربران میتوانند حاشیه سود کل محصول را بخورند، بدون اینکه در داشبورد درآمد نشانهای دیده شود. برداشت ما این است که تیمهای محصول باید قیمتگذاری را به واحدی گره بزنند که با هزینه همجهت حرکت کند: هر کار، هر نتیجه یا سهمیههای مصرفی شفاف، نه دسترسی نامحدود.
برندهها احتمالاً سازمانهاییاند که مسیریابی مدل دارند؛ یعنی کار ساده را به مدل کوچک و ارزان میسپارند و استدلال سنگین را فقط جایی فعال میکنند که ارزش آن اثبات شده است. بازندهها فروشندگانیاند که قیمت ثابت دادهاند و هزینه متغیر را نمیسنجند. برای تیم داده، درس روشن است: توکنهای تفکر، تعداد تکرارها و تلاشهای مجدد باید در کنار نتیجه نهایی ثبت شوند تا هزینه هر کار موفق، و نه هزینه هر فراخوانی، محاسبهپذیر شود. تیم بازاریابی هم میتواند از وعده نامحدود پرهیز کند.
اثر مرتبه دوم محتمل این است که کارایی توکنی به معیار خرید تبدیل شود؛ یعنی مدلها نه فقط با دقت و قیمت هر میلیون توکن، بلکه با تعداد توکن لازم برای انجام یک کار معین مقایسه شوند. سرتیترهایی که از ارزانشدن چشمگیر هوش مصنوعی خبر میدهند، درباره قیمت یک سطح ثابت توانایی درستاند، اما برای بودجهریزی گمراهکنندهاند؛ و در طرف مقابل، این ادعا که هزینه کل سازمانها لزوماً بالا رفته هم هنوز با دادههای این منابع اثبات نشده است. آنچه میتوان با اطمینان گفت این است که بدون سنجش هزینه هر کار، هیچیک از این دو روایت برای سازمان قابل آزمون نیست.
| شاخص | مقدار گزارششده | منبع |
|---|---|---|
| کاهش سالانه قیمت برای عملکرد ثابت | ۹ تا ۹۰۰ برابر، بسته به وظیفه | Epoch AI و AI Index |
| سطح GPT-4 در سؤالات علمی سطح دکتری | ۴۰ برابر کاهش در سال | Epoch AI |
| روند کلی هزینه برای توانایی معین | حدود ۵ تا ۱۰ برابر کاهش در سال | Epoch AI |
| توکن خروجی برای حدود ۲۷ درصد دقت در FrontierMath | ۴۳ میلیون در آوریل ۲۰۲۵؛ ۵ میلیون در دسامبر ۲۰۲۵ | Epoch AI |
| هزینه سختافزار یادگیری ماشین به ازای عملکرد | ۳۰ درصد کاهش در سال | AI Index |
خط زمانی
- 2022-11: هزینه مدل همسطح GPT-3.5 در MMLU معادل ۲۰ دلار برای هر میلیون توکن[۱][۳]
- 2023-03: GPT-3.5 Turbo همین سطح را با ۲ دلار برای هر میلیون توکن ارائه کرد[۱]
- 2024-10: Gemini-1.5-Flash-8B همان سطح را با ۰٫۰۷ دلار برای هر میلیون توکن ارائه کرد[۱][۳]
- 2025-04: حدود ۴۳ میلیون توکن خروجی با o4-mini برای حدود ۲۷ درصد دقت در FrontierMath[۲]
- 2025-12: حدود ۵ میلیون توکن با GPT-5.2 برای همان سطح دقت؛ حدود ۳ برابر کاهش هزینه در ۸ ماه[۲]
برای کسبوکارهای ایرانی
برای تیمهایی در ایران که مدلهای با وزن باز را روی زیرساخت خود اجرا میکنند، این بحث شکل دیگری پیدا میکند اما از بین نمیرود. Thoughtworks استفاده از مدلهای متنباز و مدلهای کوچکتر روی زیرساخت خود سازمان را راهی برای کاهش وابستگی به ارائهدهنده میداند[۵]. به نظر میرسد در این حالت هزینه به جای صورتحساب توکن در زمان GPU و انرژی ظاهر میشود و توکنهای تفکر و حلقههای عامل همچنان همان ظرفیت را مصرف میکنند. بنابراین سنجش هزینه هر کار انجامشده و انتخاب کوچکترین مدلی که کار را درست انجام میدهد، برای این تیمها هم میتواند منطقیترین نقطه شروع باشد.
چه چیزی را باید دنبال کرد
- آیا روند ۵ تا ۱۰ برابری کاهش هزینه برای توانایی ثابت ادامه مییابد یا همانطور که Epoch AI احتمال میدهد کند میشود.
- آیا ارائهدهندگان مدل گزارش توکنهای تفکر و مصرف هر کار را در صورتحسابها شفافتر میکنند.
- حرکت ابزارهای برنامهنویسی و عاملها از اشتراک ثابت به مدل اعتباری و مصرفی و اثر آن بر بودجه تیمها.
- ظهور معیارهایی که مدلها را با تعداد توکن لازم برای انجام یک کار معین مقایسه میکنند، نه فقط با دقت و قیمت فهرست.
دادههای مرتبط در همین سایت: تورم سالانه قیمت مصرفکننده: آمریکا و میانگین OECD، دانلود روزانه کیتهای توسعه هوش مصنوعی در npm
منابع
- LLM inference prices have fallen rapidly but unequally across tasks — Epoch AI، منبع مرجع، دسترسی: 2026-09-16
- How persistent is the inference cost burden? — Epoch AI، منبع مرجع، دسترسی: 2026-09-18
- Research and Development — hai.stanford.edu، منبع مرجع، دسترسی: 2026-09-16
- Agentic AI Enterprise Token Cost — EY_US، منبع مرجع، دسترسی: 2026-09-18
- The dangers of token usage billing — Thoughtworks، منبع مرجع، دسترسی: 2026-09-18
- Extended thinking — Claude Platform Docs، انتشار: 2025-05-14، شواهد تازه، دسترسی: 2026-09-18
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-18.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر