مدل دقیق، احتمال غلط: چرا تصمیمهای پرهزینه علاوه بر AUC به کالیبراسیون نیاز دارند
AUC بالا تضمین نمیکند احتمالی که مدل میدهد درست باشد. کالیبرهنبودن آستانه تصمیم، بودجه ضدریزش و قیمتگذاری ریسک اعتباری را منحرف میکند.
فهرست مطالب
وقتی مدل ریزش برای یک مشتری احتمال بالایی برمیگرداند، تیم بازاریابی معمولاً آن را نرخ واقعی ترک در میان مشتریان مشابه میخواند. مستندات scikit-learn هم طبقهبند خوشکالیبره را همینگونه تعریف میکند: از میان نمونههایی که احتمالی نزدیک ۰٫۸ گرفتهاند، حدود ۸۰ درصد واقعاً به کلاس مثبت تعلق داشته باشند[۳]. همین مستندات هشدار میدهد که بعضی مدلها احتمال کلاسها را ضعیف برآورد میکنند[۳]. برداشت ما این است که هر جا خروجی مدل در یک فرمول هزینه ضرب میشود، مثل قیمتگذاری ریسک، بودجه تخفیف ضدریزش یا آستانه ارجاع پاسخ به کارشناس انسانی، مرتبکردن درست مشتریها کافی نیست و خود عدد احتمال هم باید قابل اتکا باشد. شواهد اما یک اصلاح مهم را هم به این ادعا اضافه میکنند: همه مدلها بیشاعتماد نیستند و جهت خطا به نوع مدل بستگی دارد.
واقعیتهای کلیدی
- در یک طبقهبند خوشکالیبره، از میان نمونههایی که احتمالی نزدیک ۰٫۸ گرفتهاند، حدود ۸۰ درصد واقعاً مثبتاند.[۳]
- کالیبراسیون یک تبدیل یکنواست و ROC AUC و دیگر معیارهای رتبهای را تغییر نمیدهد.[۴]
- شبکههای عصبی مدرن کالیبراسیون ضعیفی دارند و temperature scaling روی بیشتر مجموعهدادهها مؤثر است.[۱]
- Naive Bayes احتمالها را به ۰ و ۱ میراند، اما جنگل تصادفی و LinearSVC کماعتمادند.[۳][۴]
- اطمینانی که مدلهای زبانی خودشان اعلام میکنند بهطور سیستماتیک بیش از واقع است، بهویژه در مدلهای تنظیمشده برای پیروی از دستور.[۶]
- در برآورد یک تحلیل روی داده IBM Telco، نسبت هزینه منفی کاذب به مثبت کاذب ۱۳٫۲ به ۱ است.[۷]
AUC خوب است، اما چیزی از درستیِ احتمالها نمیگوید
مثال رسمی scikit-learn روی یک داده مصنوعی با ۱۰۰٬۰۰۰ نمونه و ۲۰ ویژگی نشان میدهد که کالیبراسیون، Brier و log loss را بهتر میکند اما precision، recall و F1 را به شکل معناداری تغییر نمیدهد[۴]. طبق همین مثال، ROC AUC اصلاً تغییر نمیکند، چون کالیبراسیون یک تبدیل یکنواست و روی هیچ معیار رتبهای اثر نمیگذارد[۴]. به تعبیر همین مستند، فایده کالیبراسیون این است که احتمالها را دقیقتر و برای تصمیمهای تخصیص منابع در شرایط عدم قطعیت مفیدتر میکند[۴]. نتیجه منطقی این است که دو مدل با AUC کاملاً یکسان ممکن است احتمالهای بسیار متفاوتی تحویل دهند.
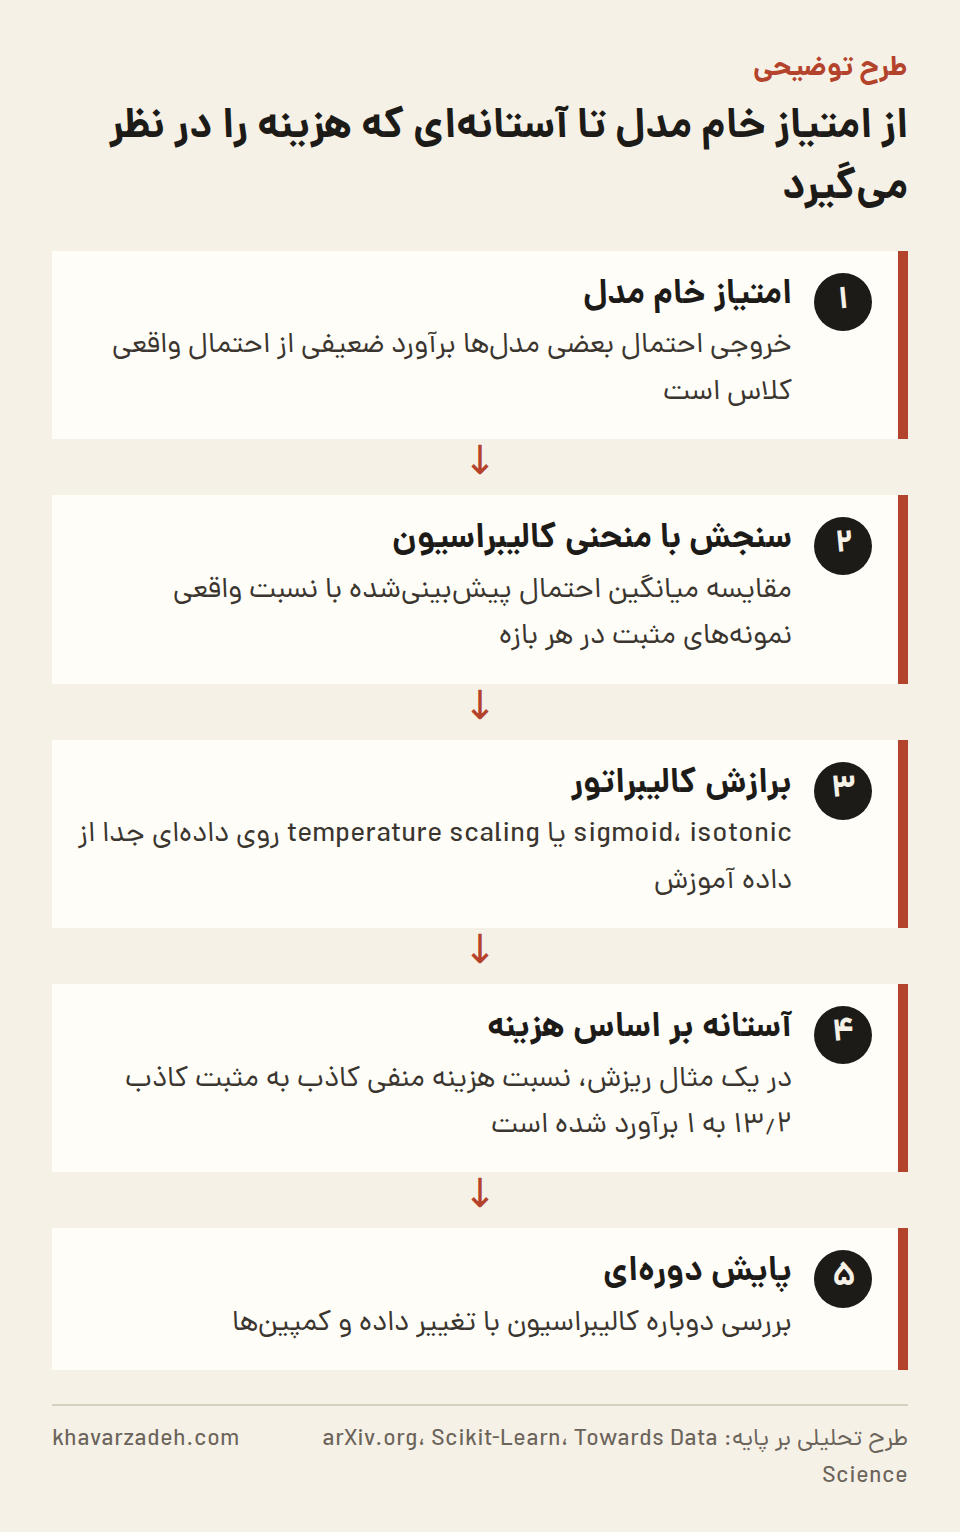
حتی Brier هم معیار خالصی برای کالیبراسیون نیست[۳]. مستندات scikit-learn توضیح میدهد که Brier و log loss همزمان سه چیز را اندازه میگیرند: کالیبراسیون، قدرت تفکیک و تصادفیبودن ذاتی دادهها[۳]. به همین دلیل Brier پایینتر لزوماً به معنای مدلی خوشکالیبرهتر نیست و ممکن است مدلی بدتر کالیبرهشده فقط قدرت تفکیک بیشتری داشته باشد[۳]. ابزار مستقیم برای دیدن این شکاف، منحنی کالیبراسیون یا نمودار اطمینانپذیری است[۳]. در این نمودار، پیشبینیها در بازههایی دستهبندی میشوند و میانگین احتمال پیشبینیشده در هر بازه با نسبت واقعی نمونههای مثبت آن بازه مقایسه میشود[۳]. یک پژوهش مروری این نمودار را استاندارد طلایی برای نمایش کالیبراسیون میداند[۲].
بیشاعتماد یا کماعتماد: جهت خطا به نوع مدل بستگی دارد
پژوهش Guo و همکاران نشان داده بود که شبکههای عصبی مدرن، برخلاف شبکههای یک دهه پیش از خود، کالیبراسیون ضعیفی دارند[۱]. در آن پژوهش، عمق، پهنا، weight decay و Batch Normalization از عوامل مؤثر بر کالیبراسیون شناخته شدند[۱]. همان پژوهش نشان داد temperature scaling، که نسخه تکپارامتری Platt scaling است، روی بیشتر مجموعهدادهها به شکل غافلگیرکنندهای مؤثر است[۱].
اما این تصویر را نمیشود به همه مدلها تعمیم داد. طبق مستندات scikit-learn، Naive Bayes گاوسی احتمالها را به سمت ۰ و ۱ میراند[۳]. جنگل تصادفی رفتار عکس دارد: قلههای توزیعش حدود ۰٫۲ و ۰٫۹ است و احتمالهای نزدیک ۰ یا ۱ در آن کمیاباند[۳]. LinearSVC هم منحنیای سیگموئیدی دارد که نشانه کماعتمادی است[۴]. در مقابل، رگرسیون لجستیکی که درست مشخص شده و منظمسازی مناسبی دارد، معمولاً بدون هیچ اصلاحی احتمالهای خوشکالیبرهای میدهد[۳]. منابع این یادداشت درباره مدلهای تقویتشده (boosting) داده مستقیمی ارائه نمیکنند، بنابراین تعمیم بیشاعتمادی به این خانواده را باید با اندازهگیری روی داده خود سازمان سنجید.
در مدلهای زبانی، پژوهشی از ژانویه ۲۰۲۴ نشان داده بود که اعتبار نمره اطمینانی که مدل خودش اعلام میکند، بهشدت به شیوه پرسیدن بستگی دارد و با بعضی روشهای پرامپتنویسی میتوان نمرههای خوشکالیبره گرفت[۵]. ارزیابی تازهتری از ژوئن ۲۰۲۵ به این نتیجه رسید که اطمینانِ اعلامشده بهطور سیستماتیک بیش از واقع است، بهویژه در مدلهایی که برای پیروی از دستور تنظیم شدهاند[۶]. همین ارزیابی نشان داد که احتمالِ دنباله خروجی هم به پاسخهای غلط احتمال بیش از حد بالایی میدهد[۶]. در آزمایشهای آن پژوهش، که روی ۴ وظیفه پرسشوپاسخ و با یک مدل متنباز انجام شد، روش ترکیبی CoCoA در مجموع بهترین اعتبار را داشت[۶].
آستانه ۰٫۵ در واقع یک تصمیم قیمتگذاری پنهان است
یک تحلیل در Towards Data Science استدلال میکند که استفاده از آستانه پیشفرض ۰٫۵ در مدل ریزش یعنی فرض کردهایم هزینه فرستادن پیشنهاد به مشتری وفادار با هزینه از دست دادن مشتری در حال ترک برابر است[۷]. نویسنده روی داده IBM Telco هزینه یک منفی کاذب را ۱٬۳۱۶٫۴۰ دلار و هزینه یک مثبت کاذب را حدود ۱۰۰ دلار برآورد کرده که نسبت ۱۳٫۲ به ۱ را میسازد[۷]. خود او این اعداد را جاینگهدار میداند، نه مقادیر قطعی[۷]. به برآورد او، مدلهایی که با آستانه پیشفرض کار میکنند روی بخش آزمون ۲۰ درصدی حدود ۸۶ دلار برای هر مشتری هزینه قابلاجتناب ایجاد میکنند[۷].
این نویسنده ۳۶ تحلیل عمومی از همین داده را بررسی کرده است[۷]. طبق گزارش او، معیارهایی مثل F1، accuracy و AUC در ۸۰ تا ۹۰ درصد این تحلیلها آمدهاند، اما منحنی سود در کمتر از ۱۵ درصد آنها دیده میشود[۷]. او همچنین گزارش میدهد که وقتی مدل روی دادهای که با SMOTE متوازن شده آموزش میبیند، فرمول کتابی آستانه بهینه بیزی از جستوجوی مستقیم روی آستانهها عقب میماند[۷]. برداشت ما این است که علت احتمالی این است که آن فرمول احتمال کالیبره را فرض میگیرد، در حالی که متوازنسازی مصنوعی توزیع احتمالها را جابهجا میکند. در حوزه اعتبار هم پژوهشی مروری یادآوری میکند که مدلهای ریسک اعتباری کالیبرهنشده میتوانند به سوگیری سیستماتیک در وامدهی، ناسازگاری با الزامات نظارتی و زیان اقتصادی قابلتوجه منجر شوند[۲].
تیمهای داده، محصول و بازاریابی چه چیزی را باید تغییر دهند
عنوان این یادداشت کمی اغراق دارد و بهتر است دقیقترش کنیم. کالیبراسیون جای AUC را نمیگیرد، چون ترتیب مشتریها را تغییر نمیدهد و نمیتواند مدلی را که قدرت تفکیک ندارد نجات دهد. حرف درست این است که AUC به این پرسش پاسخ میدهد که چه کسی بالاتر از چه کسی است، و کالیبراسیون به این پرسش که چقدر بالاتر. هر تصمیمی که بر ارزش مورد انتظار استوار است، یعنی حاصلضرب سود در احتمال، به هر دو پاسخ نیاز دارد.
در عمل، به نظر میرسد سه تغییر کمهزینه بیشترین اثر را دارند. اول، گزارش هر مدلی که به بودجه وصل است، علاوه بر AUC، نمودار کالیبراسیون و منحنی سود را هم داشته باشد. دوم، کالیبراتور روی دادهای جدا از داده آموزش برازش شود. سوم، آستانه از نسبت هزینه واقعی خطاها استخراج شود، نه از عدد پیشفرض کتابخانه. برای تیمهایی که مدل زبانی را در مسیر پشتیبانی یا بررسی اسناد به کار میبرند، نمره اطمینانِ اعلامشده توسط خود مدل را نمیتوان مستقیم بهعنوان آستانه ارجاع به انسان استفاده کرد، مگر آنکه پیش از آن روی داده برچسبخورده سنجیده شده باشد.
یک اثر مرتبه دوم محتمل هم وجود دارد. وقتی احتمالها قابل اعتماد شوند، بحث بودجه بازاریابی از فهرست پرریسکترین مشتریها به محاسبه ارزش مورد انتظار هر مشتری منتقل میشود. در این حالت ممکن است معلوم شود بخشی از تخفیفها به مشتریانی داده میشد که اصلاً قصد رفتن نداشتند. این هم نکتهای درباره مالکیت است: کالیبراسیون فقط مسئله تیم داده نیست، چون نسبت هزینهها را تیم مالی و بازاریابی تعیین میکنند.
| خانواده مدل | رفتار احتمال خام | راه اصلاح مطرحشده |
|---|---|---|
| رگرسیون لجستیک با منظمسازی مناسب | معمولاً خوشکالیبره | اغلب نیازی نیست |
| Naive Bayes گاوسی | بیشاعتماد؛ احتمالها به ۰ و ۱ رانده میشوند | رگرسیون isotonic یا sigmoid |
| جنگل تصادفی | کماعتماد؛ قلهها حدود ۰٫۲ و ۰٫۹ | کالیبراتور روی داده مستقل |
| LinearSVC | کماعتماد؛ منحنی سیگموئیدی | sigmoid یا isotonic |
| شبکههای عصبی مدرن | کالیبراسیون ضعیف | temperature scaling |
| مدل زبانی، اطمینانِ اعلامشده توسط خود مدل | بیشبرآورد سیستماتیک | روشهای ترکیبی مانند CoCoA |
برای کسبوکارهای ایرانی
برای تیمهایی در ایران که بیشتر به ابزارهای متنباز متکیاند، کالیبراسیون از معدود بهبودهایی است که به زیرساخت یا سرویس خارجی نیاز ندارد، چون کلاس CalibratedClassifierCV بخشی از خود scikit-learn است[۳]. در مدلهای زبانی، روشهایی که به حالت داخلی مدل مثل logitهای توکن تکیه دارند، روی مدلهای جعبهسیاه قابل اتکا نیستند[۵]. برداشت ما این است که اجرای مدلهای متنباز روی سرور خود سازمان میتواند دست تیم را برای سنجش و کالیبرهکردن اطمینان مدل بازتر بگذارد.
چه چیزی را باید دنبال کرد
- اینکه ارزیابیهایی مثل پژوهش ژوئن ۲۰۲۵، که با یک مدل متنباز و ۴ وظیفه پرسشوپاسخ انجام شد، به مدلها و وظایف بیشتری گسترش پیدا کنند و برتری روشهای ترکیبی تأیید شود.
- اینکه گزارش مدلهای ریزش و ریسک اعتباری در سازمانها، کنار AUC و F1، نمودار کالیبراسیون و منحنی سود را هم بهصورت استاندارد شامل شود.
- پایش دورهای کالیبراسیون پس از تغییر ترکیب مشتریان یا کمپینها؛ مدلی که امروز کالیبره است ممکن است با تغییر داده این ویژگی را از دست بدهد.
- اثر روشهای متوازنسازی مانند SMOTE بر احتمالهای خروجی و آستانه بهینه در پروژههای واقعی.
منابع
- On Calibration of Modern Neural Networks — arXiv.org، منبع مرجع، دسترسی: 2026-09-18
- Calibration Meets Reality: Making Machine Learning Predictions Trustworthy — arxiv.org، منبع مرجع، دسترسی: 2026-09-18
- 1.16. Probability calibration — Scikit-Learn، منبع مرجع، دسترسی: 2026-09-18
- Probability Calibration curves — Scikit-Learn، منبع مرجع، دسترسی: 2026-09-18
- On Verbalized Confidence Scores for LLMs — arxiv.org، انتشار: 2024-01-25، مرجع پایه، دسترسی: 2026-09-18
- Systematic Evaluation of Uncertainty Estimation Methods in Large Language Models — arxiv.org، انتشار: 2025-06-10، شواهد تازه، دسترسی: 2026-09-18
- Your Churn Threshold Is a Pricing Decision | Towards Data Science — Towards Data Science، منبع مرجع، دسترسی: 2026-09-18
روش تهیه: این تحلیل با سامانه پایش خودکار khavarzadeh.com و کمک مدلهای زبانی از منابع بالا تهیه شده و پیش از انتشار، تطابق اعداد، تاریخها و ارجاعها با منابع بهصورت خودکار کنترل شده است. واقعیتها با شماره منبع مشخص شدهاند و بقیه متن برداشت تحلیلی است. تاریخ تهیه: 2026-09-18.
نظرات
هنوز نظری ثبت نشده است؛ اولین نفر باشید.
افزودن نظر